 Scientify
本页说明
教程- 这页解决什么
- 你想在单张消费级或云 GPU 上微调 7B 模型,但不清楚 QLoRA 配置怎么写、需要多大显存、怎么判断微调是否真的有效。
- 适合谁
- 第一次做大模型微调的研究生和工程师。需要会用 Linux 命令行和 Python,了解训练集、验证集和测试集的区别。
- 读完你会得到
- 读完会得到一份可直接使用的 QLoRA 配置、一套判断微调效果的评测方法,以及一份 7B 模型在 PubMedQA 上的完整实测结果。
- 覆盖
- LLaMA-Factory 的数据格式与 dataset_info.json 注册
- QLoRA 配置逐项说明(rank、alpha、学习率、梯度累积等)
- 真实显存峰值与 GPU 选择
- 如何确认 4 bit 量化真的生效
- 零样本基线、配对 bootstrap 置信区间与多种子检验
- 逐类指标与微调后类别退化的读法
- 不覆盖
- 全参数微调与多卡分布式训练
- DPO、RLHF 等偏好对齐方法
- 模型合并导出与部署
主线:一步步做完
准备
为什么做这一步先装好 LLaMA-Factory 并确认命令可用。
WebUI 适合第一次熟悉参数;需要复现和记录的实验,用 YAML 配置加命令行更好管理,本页全部使用命令行。
服务器上已经装好 PyTorch 时,建议新建虚拟环境并复用已有的 PyTorch,按 LLaMA-Factory 声明的版本范围安装其他依赖,不要替换 CUDA 环境。
git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e .
pip install -r requirements/metrics.txt
# QLoRA 还需要 bitsandbytes
pip install bitsandbytesllamafactory-cli webui
llamafactory-cli train train.yaml第 1 步
为什么做这一步微调数据要转成 LLaMA-Factory 认识的格式,并在 dataset_info.json 里注册。
PubMedQA 的专家标注集(PQA-L)有 1,000 道题,每题给出一个生物医学研究问题和去掉结论的论文摘要,要求回答 yes、no 或 maybe。本例用官方脚本划分,训练 450、开发 50、测试 500,三个集合之间没有重复。
训练和开发数据转成 instruction / input / output 三字段的 JSON:instruction 放问题和摘要,output 只放答案。测试集不注册到 dataset_info.json,避免被训练流程读到。
{
  "instruction": "Question: ...\nCONTEXTS: ...\nAnswer with yes, no, or maybe.",
  "input": "",
  "output": "yes"
}{
"pubmedqa_train": { "file_name": "train.json" },
"pubmedqa_dev": { "file_name": "dev.json" }
}| 集合 | 题数 | yes | no | maybe |
|---|---|---|---|---|
| 测试集 | 500 | 276 | 169 | 55 |
第 2 步
为什么做这一步按显存峰值选 GPU,选小了会 OOM,选大了浪费钱。
本例按显存 14 GB、内存 24 GB、4 核 CPU、60 GB 磁盘估算,乘以 1.25 的余量后,选了 AWS g5.2xlarge(A10G 24 GB、8 核、32 GB 内存)。14 GB 乘以 1.25 为 17.5 GB,超过 T4 的 16 GB;T4 也不支持 bf16,用它需要把 bf16 改成 fp16。
模型权重约 15 GB,下载用时 140 秒。基础模型和 Python 环境放在 GPU 服务器上,只把适配器、预测和日志同步回来。
| 运行方式 | 显存峰值(实测) | 说明 |
|---|---|---|
| QLoRA(4 bit NF4)训练 | 7.25 GiB(PyTorch 分配)/ 8.55 GiB(含缓存) | nvidia-smi 采样最高 9,213 MiB |
| 零样本推理(4 bit) | 6.59 GiB | batch 4 |
| 误跑的 BF16 LoRA 训练 | 约 22 GiB(22,587 MiB) | 量化未生效时的实际占用 |
第 3 步
为什么做这一步没有同协议的基线,就无法说明微调带来了多少提升。
基线和微调后的模型使用完全相同的评测协议:同一个 Qwen 对话模板、同一句提示、同样的 4 bit NF4 加载、贪心解码、最多生成 8 个 token。输出必须完整匹配 yes、no 或 maybe(忽略大小写和末尾句号),否则判为无效并计错,不从解释文字里抽答案。
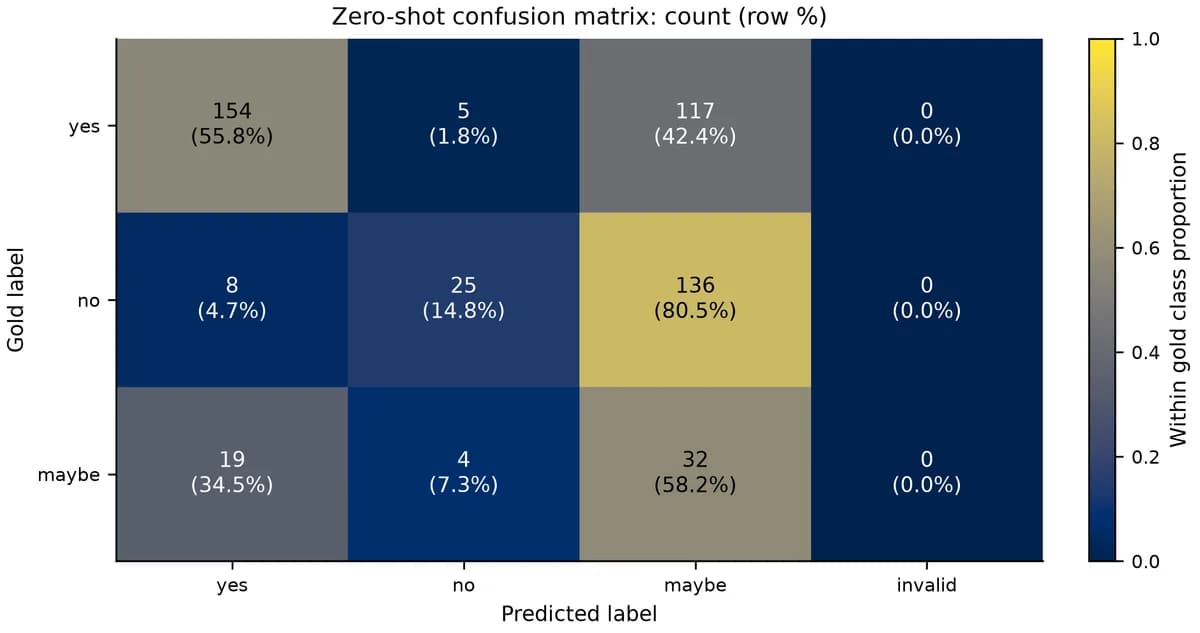
500 道测试题的基线推理用时约 3 分钟,准确率 42.2%,低于全答 yes 的 55.2%。原因是原模型大量回答 maybe:276 道 yes 题里有 117 道答成 maybe,169 道 no 题里有 136 道答成 maybe。
第 4 步
为什么做这一步把每个参数的取值和理由写清楚,复现和调参时才有依据。
LLaMA-Factory 的 LoRA 通过 PEFT 库实现:基础模型冻结,只在指定线性层上训练低秩矩阵 A、B。QLoRA 在此基础上用 bitsandbytes 把冻结的基础权重以 4 bit 加载。下面是本次正式配置的主要字段。
model_name_or_path: /path/to/Qwen2.5-7B-Instruct
stage: sft
do_train: true
finetuning_type: lora
lora_target: all
lora_rank: 16
lora_alpha: 32
lora_dropout: 0.05
quantization_bit: 4
quantization_method: bnb      # 必须写 bnb
quantization_type: nf4
double_quantization: true
dataset: pubmedqa_train
eval_dataset: pubmedqa_dev
template: qwen
cutoff_len: 2048
train_on_prompt: false
per_device_train_batch_size: 1
gradient_accumulation_steps: 16
learning_rate: 1.0e-4
num_train_epochs: 3
lr_scheduler_type: cosine
warmup_ratio: 0.05
bf16: true
gradient_checkpointing: true
optim: paged_adamw_8bit
eval_strategy: epoch
save_strategy: epoch
load_best_model_at_end: true
metric_for_best_model: eval_lossllamafactory-cli train train.yaml| 参数 | 取值 | 作用 |
|---|---|---|
| lora_target | all | 在所有线性层上加 LoRA |
| lora_rank / lora_alpha | 16 / 32 | 低秩维度与缩放系数 |
| quantization_bit / method | 4 / bnb | 基础权重以 4 bit 加载并冻结 |
| quantization_type / double_quantization | nf4 / true | NF4 量化,并压缩量化尺度 |
| batch × 梯度累积 | 1 × 16 | 等效 batch 16,单卡显存最省 |
| learning_rate / epochs | 1e-4 / 3 | 小数据集的有限训练预算 |
| train_on_prompt | false | 只对答案计算损失,不学习复述摘要 |
| load_best_model_at_end | true,按 eval_loss | 训练结束后载入开发集损失最低的检查点 |
第 5 步
为什么做这一步配置里写了 4 bit,不代表模型真的以 4 bit 加载。
本次第一版配置写的是 quantization_method: bitsandbytes。当时的 LLaMA-Factory 只识别 bnb 这个值,写错后没有任何报错或警告,直接跳过了量化。前两次训练实际是普通的 BF16 LoRA,显存约 22 GiB。
问题是在训练第三个种子前的运行检查中发现的:模型的 is_loaded_in_4bit 为 False,也没有 Linear4bit 层。改为 bnb 后,在训练开始时加入断言,确认 is_loaded_in_4bit 为 True、量化类型为 NF4、双重量化开启、Linear4bit 层数大于 0,然后从头重跑全部三个种子。错误的训练完整归档,报告中与正确结果分开。
import bitsandbytes as bnb

assert getattr(model, "is_loaded_in_4bit", False), "model is not 4-bit"
qc = model.config.quantization_config
assert qc.bnb_4bit_quant_type == "nf4" and qc.bnb_4bit_use_double_quant
n4 = sum(isinstance(m, bnb.nn.Linear4bit) for m in model.modules())
assert n4 > 0, "no Linear4bit layers"
print("Linear4bit layers:", n4)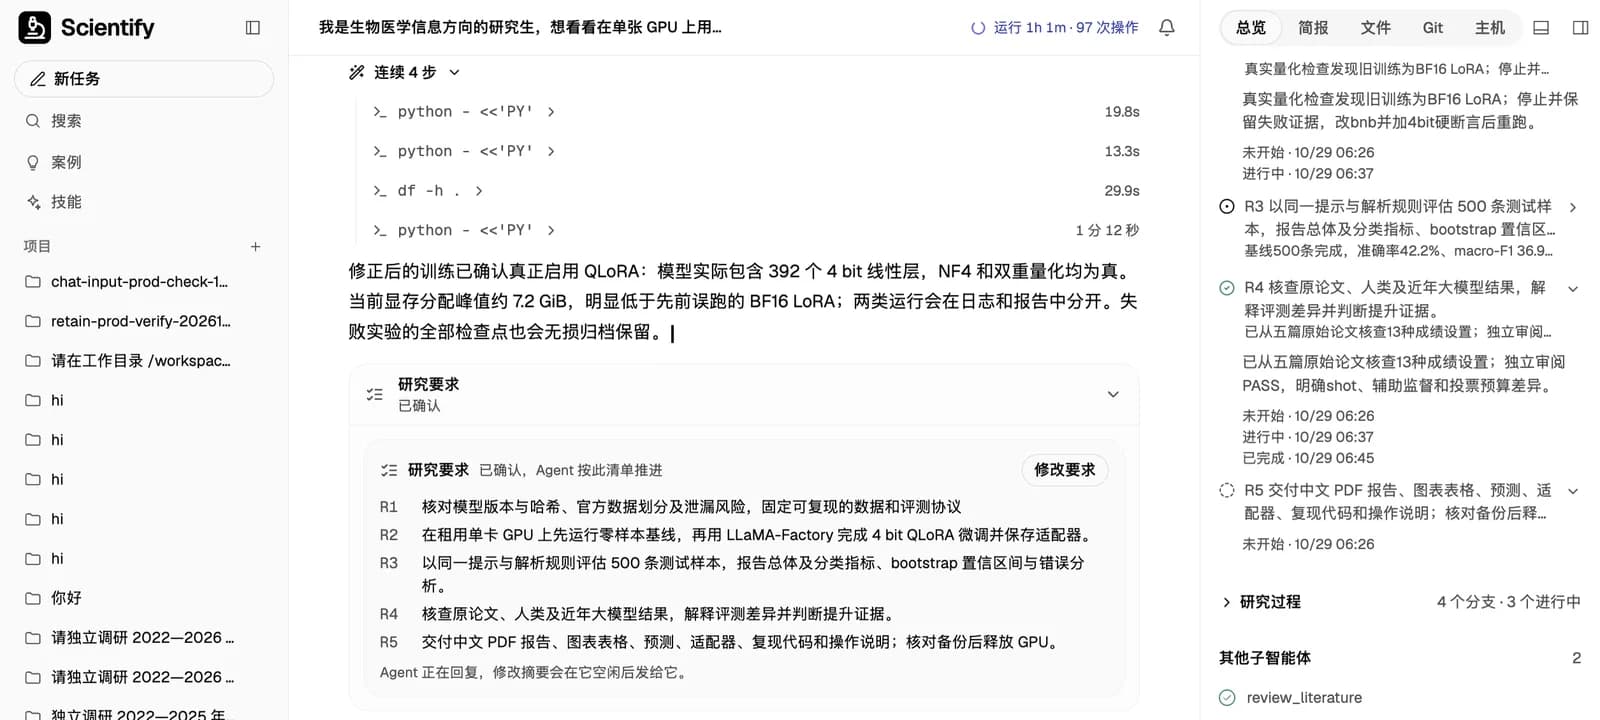
第 6 步
为什么做这一步小数据集上训练损失下降很快,不能用它判断泛化效果。
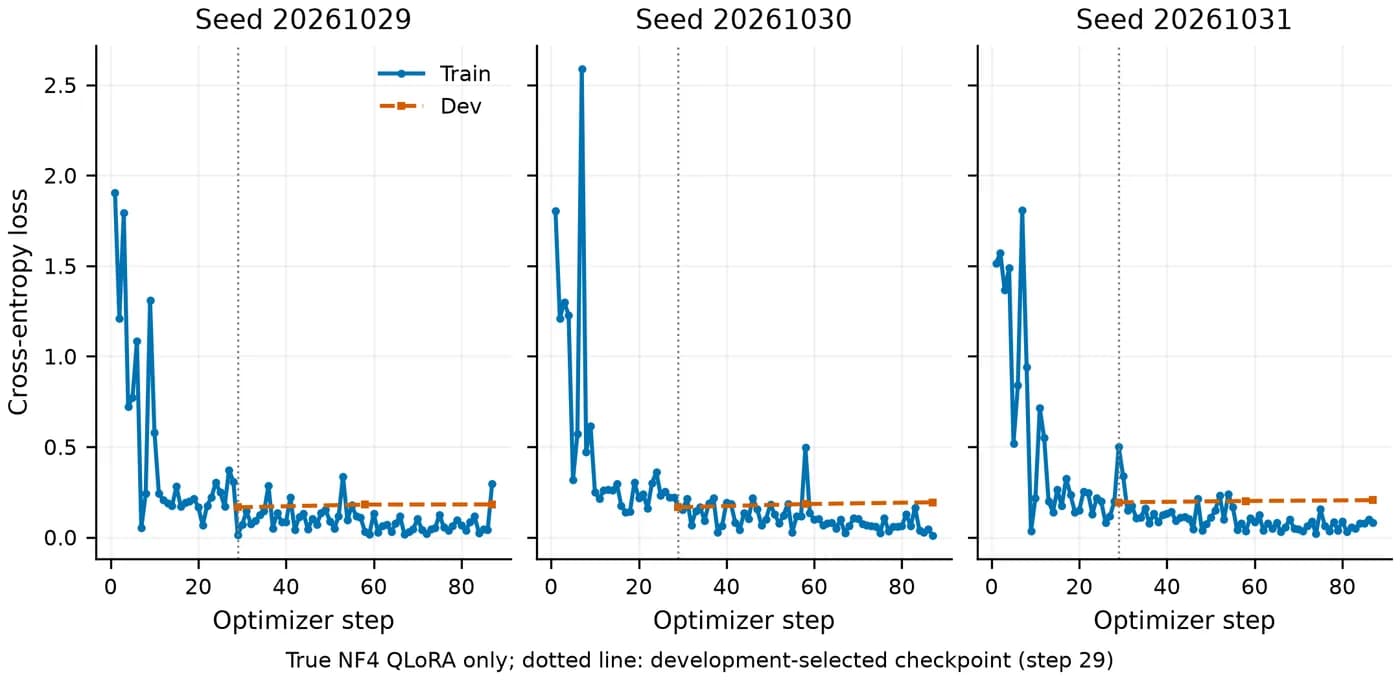
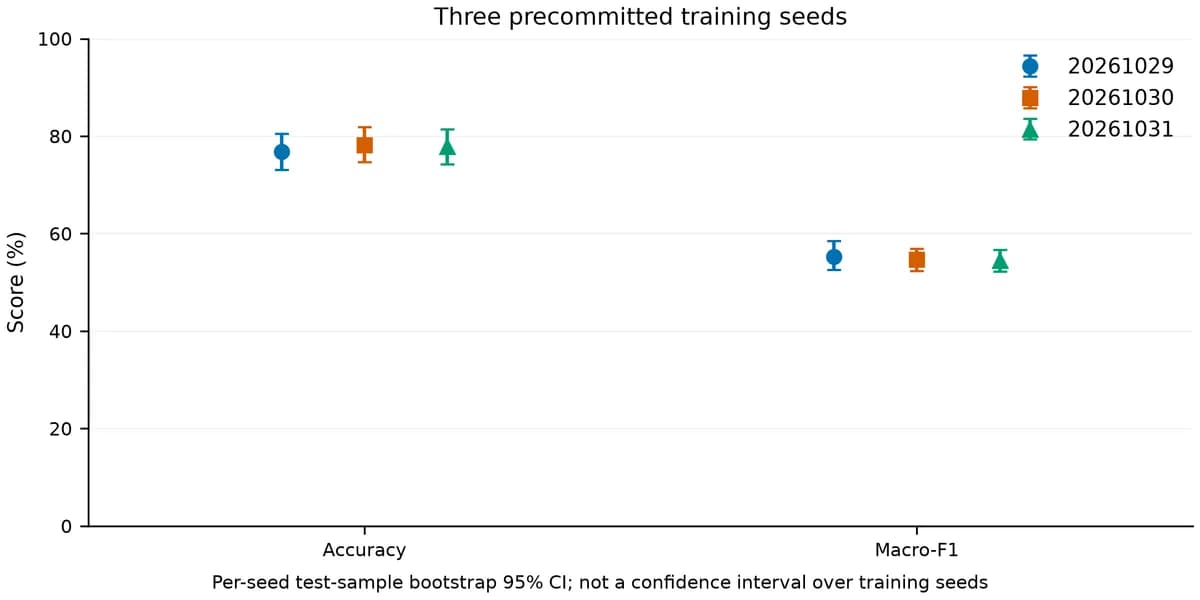
三个种子在第 1 轮后开发集损失最低,第 2、3 轮训练损失继续下降、开发集损失上升,这是小样本过拟合信号。load_best_model_at_end 会自动载入第 29 步的检查点。
开发集只有 50 题,其中 maybe 只有 6 题,按它选检查点本身有噪声。每个种子训练 87 步约 17 分钟。
第 7 步
为什么做这一步用同一批测试题比较微调前后,并检查结果在不同随机种子下是否稳定。
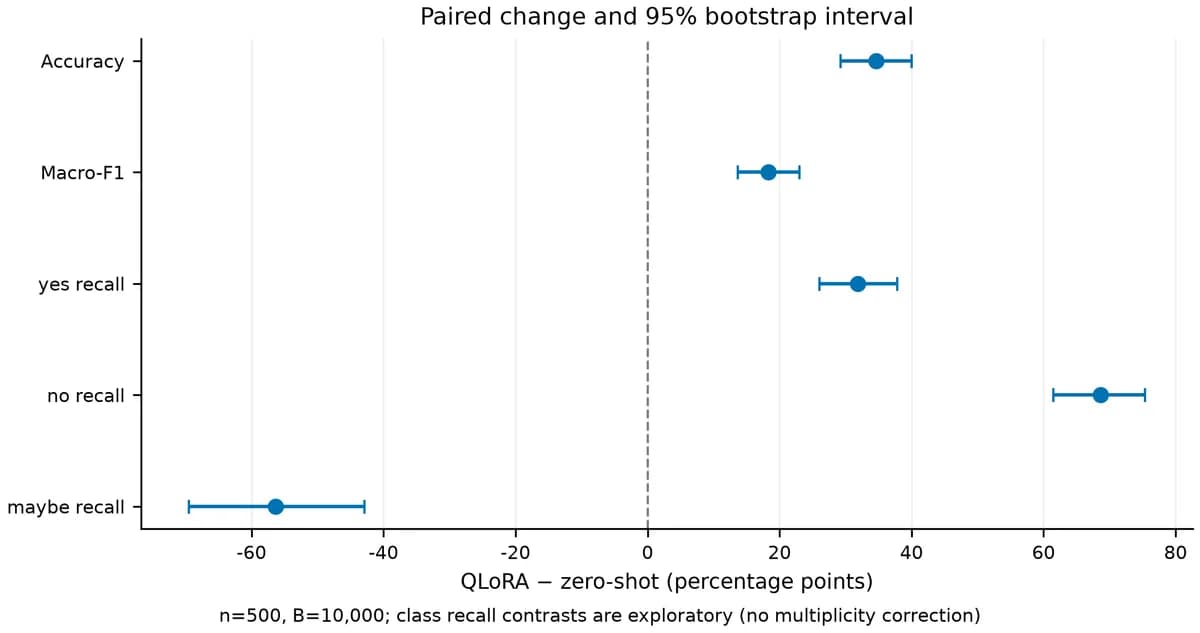
配对 bootstrap 每次对同一组测试题重采样,计算“微调减基线”的差值分布。差值的 95% CI 不包含 0,说明在这 500 题上提升是稳定的。不能用两个模型各自的置信区间是否重叠来代替配对检验,也不能把 3 个种子 × 500 题当成 1,500 道独立题。
| 指标 | 零样本基线 | QLoRA 微调(主种子) | 提升(配对 95% CI) |
|---|---|---|---|
| 准确率 | 42.2%(38.0–46.6) | 76.8%(73.0–80.4) | +34.6(+29.2 至 +40.0) |
| macro-F1 | 36.95%(33.0–40.8) | 55.28%(52.5–58.4) | +18.3(+13.7 至 +23.0) |
第 8 步
为什么做这一步总体准确率会掩盖某一类能力的退化。
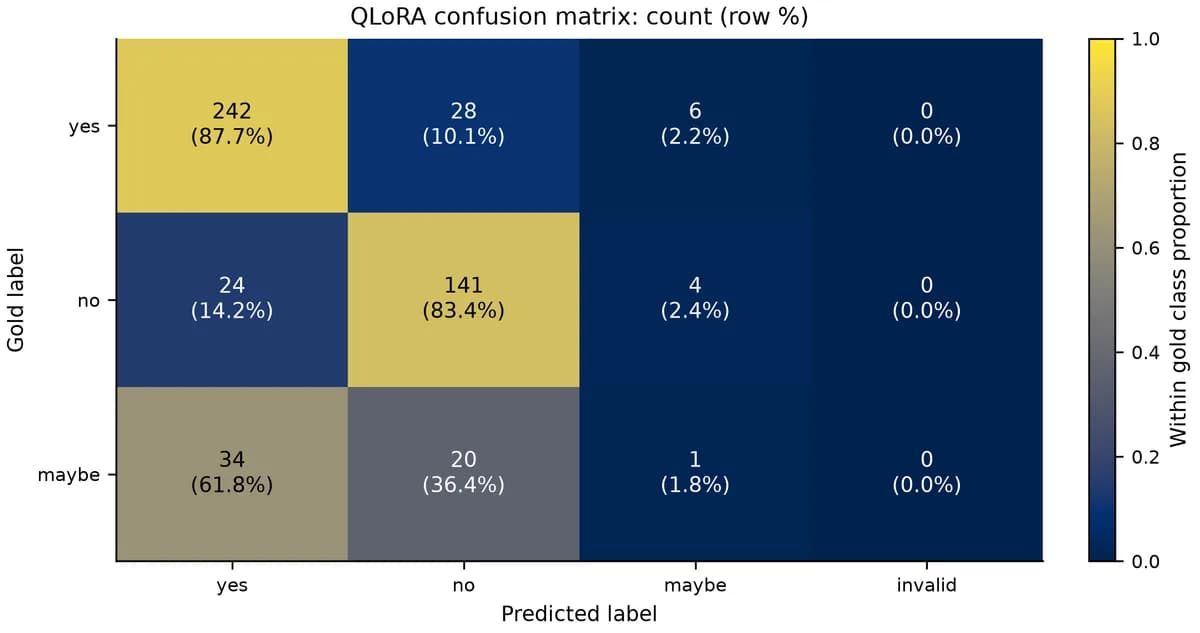
提升来自纠正 yes 和 no:原模型过度回答 maybe,微调后改正。但微调后模型几乎不再回答 maybe,表示“证据不足”的能力退化。这可能与 maybe 在数据中占比低有关(测试集 500 题中只有 55 题)。
如果应用场景需要模型在证据不足时说“不确定”,这个结果不能直接使用。可以尝试的方向是对 maybe 类加权、过采样,或把阈值调整作为单独实验,但需要新的独立测试数据来验证。PubMedQA 是离线基准,准确率不代表临床使用的安全性。
| 类别 | 题数 | 基线召回 | 微调后召回 |
|---|---|---|---|
| yes | 276 | 55.8% | 87.7% |
| no | 169 | 14.8% | 83.4% |
| maybe | 55 | 58.2% | 1.8% |
原理与判断
对照
为什么做这一步公开成绩说明量级,但设置不同,不能直接排名。
Med-PaLM 2 的 81.8% 使用少样本提示和 11 次采样投票,GPT-4 的 75.2% 是零样本单次回答,本页用 450 道专家题微调、单次贪心解码。公开论文没有逐题预测,无法与本页做配对检验,因此只作参考。
| 系统与设置 | 准确率 |
|---|---|
| 全部回答 yes | 55.2% |
| BioBERT,多阶段,有额外监督(Jin 等 2019) | 68.1% |
| GPT-4,零样本(Nori 等 2023) | 75.2% |
| 人类单标注者(Jin 等 2019) | 78.0% |
| Med-PaLM 2,优化提示 + 11 次采样自一致性(Singhal 等 2023) | 81.8% |
| 本页:Qwen2.5-7B + QLoRA,450 道专家题 | 76.8%(三种子 76.8–78.2%) |
参考与附录
运行记录
为什么做这一步说明数据来源与运行条件。
本页数字来自 2026 年 10 月 29 日在 Scientify 上的一次长周期研究任务。用户上传任务书,Scientify 自行估算资源并租用 A10G GPU,核对模型版本与数据划分,先跑基线再训练,发现量化未生效后停下、保留证据并重跑全部种子,完成评测后释放 GPU。
最终交付 11 页中文报告、8 张图、3 个 Excel、三套适配器、2,000 条逐题预测和复现代码,独立审阅通过。全程约 2 小时 40 分钟,其中 GPU 使用约 1.9 小时。
常见报错与处理
按本次实际遇到的顺序。
配置写了 4 bit,显存却和 BF16 差不多
原因:quantization_method 写成了 bitsandbytes 等框架不识别的值,量化被静默跳过。
怎么解决:改为 quantization_method: bnb,训练开始时断言 is_loaded_in_4bit 为 True 且存在 Linear4bit 层。
ModuleNotFoundError: No module named 'torchaudio'
原因:新版 LLaMA-Factory 的多模态模块无条件导入 torchaudio,而预装 PyTorch 没有匹配版本。
怎么解决:纯文本任务可以把该导入改为可选导入并记录补丁;涉及音频时安装匹配的完整环境。
CUDA out of memory
原因:量化未生效、batch 或序列长度过大。
怎么解决:先确认 4 bit 已生效;再减小 per_device_train_batch_size 或 cutoff_len,用梯度累积保持等效 batch。基线与微调要用同一协议。
transformers / peft 版本冲突
原因:直接安装最新版,超出 LLaMA-Factory pyproject 允许的范围。
怎么解决:在独立 venv 中按 LLaMA-Factory 声明的版本范围安装,复用已有的 PyTorch,不要替换 CUDA 环境。
模型输出带解释,评测判为无效
原因:生成长度过长或提示不一致。
怎么解决:限制 max_new_tokens,保持提示和解析规则不变;保留原始输出,不事后修改答案。
Please provide model_name_or_path
原因:直接调用底层 get_train_args 时传入了 YAML 路径而不是解析后的字典。
怎么解决:用 llamafactory-cli train train.yaml,或先 yaml.safe_load 再传入。