 Scientify
本页说明
教程- 这页解决什么
- 你手上有一个缺陷或目标检测数据集,想用 YOLOv8 或 YOLO11 训练,并判断训练出来的结果好不好、能不能写进报告。
- 适合谁
- 第一次用 YOLO 做课程设计、毕业设计或小论文的学生,以及做工业视觉检测的工程师。需要会用命令行和 Python。
- 读完你会得到
- 读完会得到一套可照做的训练流程,以及一份 NEU-DET 上四个模型的完整测试结果,可作为你自己实验的对照基线。
- 覆盖
- VOC XML 转 YOLO TXT 的公式和目录结构
- 按类别分层划分并处理重复图像
- data.yaml 写法与服务器上的绝对路径
- YOLOv8n/s、YOLO11n/s 在同一设置下的训练参数与真实结果
- mAP50、mAP50-95 的含义,以及 NEU-DET 上多少算正常
- 混淆矩阵、PR 曲线、逐类 AP 与错例的读法
- 不覆盖
- 标注工具(LabelImg、Roboflow)的界面操作
- 网络结构改进(注意力模块等)
- 模型部署与 TensorRT 加速
主线:一步步做完
数据集
为什么做这一步先弄清数据规模和类别,后面的划分与指标都依赖这些数字。
NEU-DET 是东北大学宋克臣团队发布的热轧钢带表面缺陷检测数据集,属于 NEU surface defect database 的检测子集。数据集共 1,800 张 200×200 灰度图,6 类缺陷各 300 张,标注为 VOC XML 格式。
本次核对得到 4,189 个标注框。其中 3 处是同一张图里完全重复的标注行,Ultralytics 读取时自动去重,实际生效 4,186 个框。图像数、框数和类别数是三个不同的量,写报告时要分开写。
| 类别 ID | 英文名 | 中文名 | 测试集框数 |
|---|---|---|---|
| 0 | crazing | 龟裂 | 107 |
| 1 | inclusion | 夹杂 | 151 |
| 2 | patches | 斑块 | 120 |
| 3 | pitted_surface | 麻点 | 63 |
| 4 | rolled-in_scale | 压入氧化皮 | 98 |
| 5 | scratches | 划痕 | 86 |
第 1 步
为什么做这一步YOLO 不读 XML。每张图需要一个同名 TXT,每行一个框。
YOLO 检测标签一行五列:class_id x_center y_center width height。后四列都按原图宽高归一化到 0–1。VOC 的 bndbox 给出的是像素角点 xmin、ymin、xmax、ymax,需要换算。
例如 200×200 的图中有一个类别 0 的框 (20, 40, 100, 120),换算后的一行是 0 0.30 0.40 0.40 0.40。同一张图有两个缺陷就写两行。
neu_det_yolo/
├── data.yaml
└── data/
    ├── images/{train,val,test}/crazing_103.jpg
└── labels/{train,val,test}/crazing_103.txtx_center = (xmin + xmax) / (2W)
y_center = (ymin + ymax) / (2H)
width = (xmax - xmin) / W
height = (ymax - ymin) / H第 2 步
为什么做这一步train 用于更新权重,val 用于选模型和早停,test 只用于最后报告成绩。
本次按图像类别分层,固定随机种子,按 70%/15%/15% 划分为 1,260/270/270 张,每类 210/45/45 张。四个模型共用同一份划分清单。
划分前先计算每张图的 SHA256。本次发现 patches_101.jpg 与 patches_105.jpg 内容完全相同,两张图放在同一个集合;如果分到 train 和 test 两边,测试成绩会偏高。
测试集不能用来挑轮数、学习率或增强参数。看过测试集错误后再改模型,需要新的独立数据来验证。
| 比例 | 优点 | 代价 |
|---|---|---|
| 70/15/15(本次) | 验证集和测试集各类都有 45 张 | 训练样本少于 80/10/10 |
| 80/10/10 | 训练数据更多 | 测试集每类只有 30 张,结果波动更大 |
| 工业数据按批次分组 | 能检验换产线、换相机后的效果 | 需要采集记录 |
第 3 步
为什么做这一步data.yaml 告诉 YOLO 三个集合的图片位置和类别名称。
train、val、test 指向图片目录,YOLO 会把路径中的 images 替换为 labels 去找标签。不同 Ultralytics 版本对相对 path 的解析不同,换到 GPU 服务器上训练时,在服务器上重新生成使用绝对路径的 data.yaml 最稳妥。
path: /absolute/path/to/neu_det_yolo/data
train: images/train
val: images/val
test: images/test
names:
  0: crazing
  1: inclusion
  2: patches
  3: pitted_surface
  4: rolled-in_scale
5: scratches第 4 步
为什么做这一步四个模型使用完全相同的参数,结果才能比较。
nvidia-smi
python -c "import torch, ultralytics; print(torch.__version__, torch.cuda.is_available(), ultralytics.__version__)"yolo detect train data=data.yaml model=yolov8n.pt \
epochs=200 patience=50 batch=16 imgsz=640 \
optimizer=SGD lr0=0.01 seed=20261027 deterministic=True \
workers=4 device=0| 参数 | 本次取值 | 说明 |
|---|---|---|
| epochs | 200 | 最多训练轮数;早停时会提前结束 |
| patience | 50 | 验证指标连续 50 轮没有提升就停止 |
| batch | 16 | T4 16 GB 显存足够 |
| imgsz | 640 | 原图 200×200 会被放大,放大不增加细节 |
| optimizer | SGD | 显式指定;optimizer=auto 会忽略 lr0 |
| model | yolov8n/s.pt、yolo11n/s.pt | 都从官方 COCO 预训练权重开始 |
第 5 步
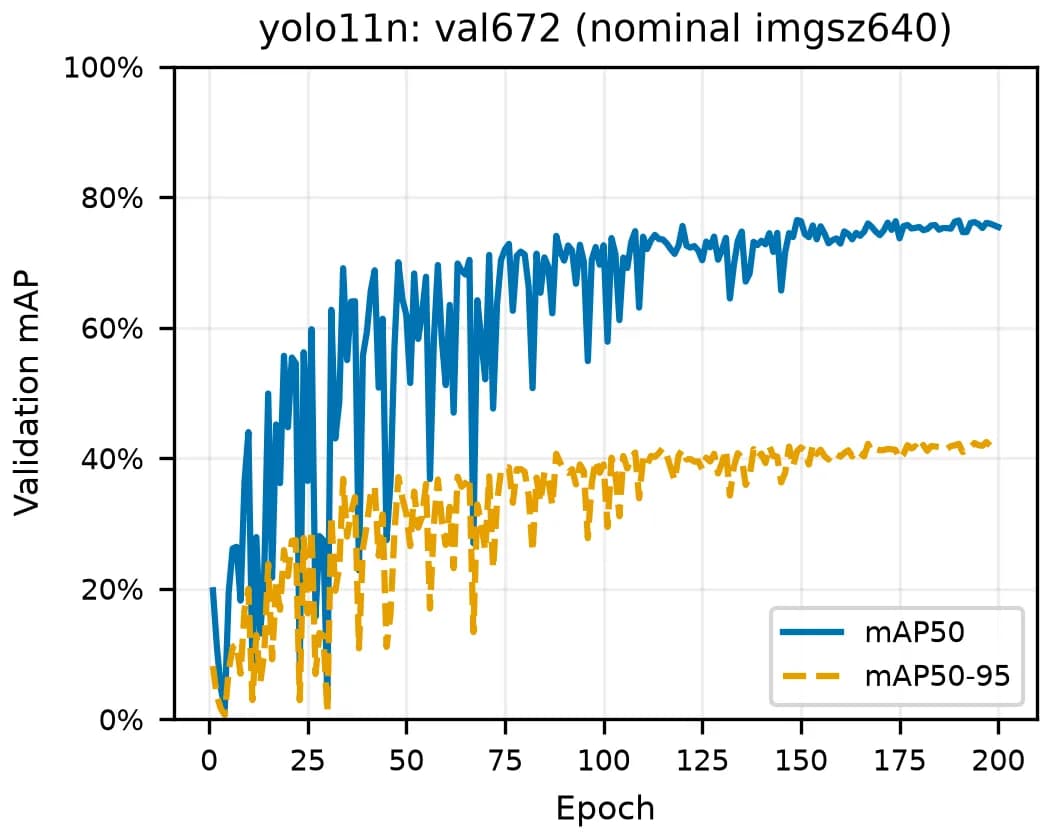
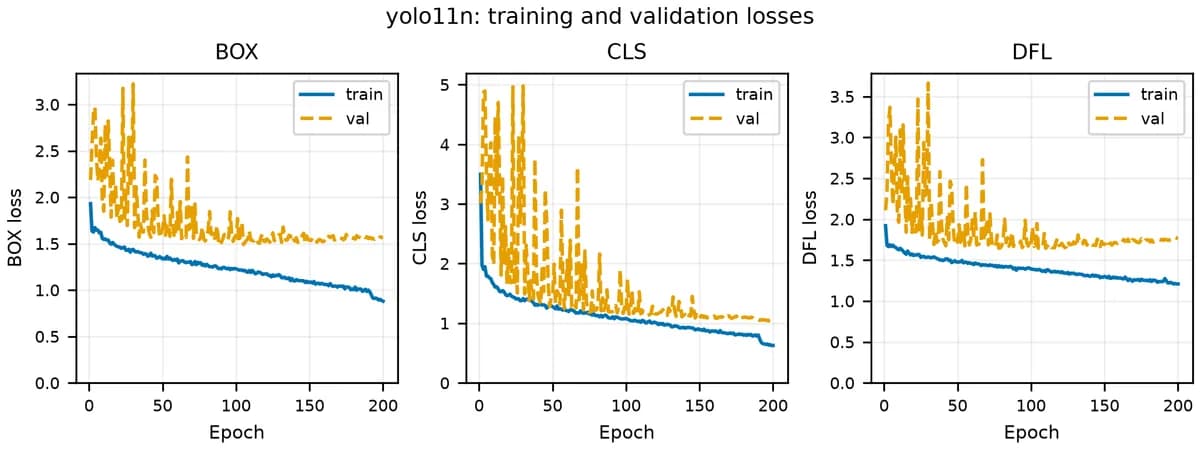
为什么做这一步曲线用来判断模型是否收敛、是否过拟合,不用来报告最终成绩。
box_loss
预测框与真实框的位置误差。越低越好,但不同模型之间不能直接比数值。
cls_loss
类别判断误差。训练损失下降而验证损失持续上升,同时验证 mAP 下降,是过拟合信号。
前期剧烈波动
NEU-DET 验证集只有 270 张,单轮 mAP 波动很大。看趋势和最后 20 轮均值,不看单个峰值。
曲线停在 200 轮之前
可能是早停,也可能是中断。要看日志确认,不要把缺的轮数补上。
第 6 步
为什么做这一步直接回答“我的 mAP 正常吗”:要和同一数据集、同一评估方式的基线比较。
IoU 是预测框与真实框交集面积除以并集面积。mAP50 是 IoU 阈值取 0.5 时各类 AP 的平均,只要求框大致对上。mAP50-95 是 IoU 从 0.50 到 0.95、每隔 0.05 取一次、共 10 个阈值的 AP 平均,要求框贴得更准,所以总是低于 mAP50。
网上常见“mAP50-95 大于 0.7 算良好”的说法没有数据集条件。NEU-DET 的缺陷边界模糊,四个模型的 mAP50-95 都在 41%–43%,五篇论文报告的 YOLOv8n mAP50 在 74.8%–78.4%。在这个数据集上,mAP50 约 75%、mAP50-95 约 42% 是正常基线水平。
| 模型 | 测试集 mAP50 | 测试集 mAP50-95 | Precision | Recall |
|---|---|---|---|---|
| YOLOv8n | 77.06% | 42.14% | 74.7% | 71.6% |
| YOLO11n | 76.60% | 42.82% | 75.2% | 69.3% |
| YOLO11s | 75.76% | 42.62% | 74.2% | 71.2% |
| YOLOv8s | 74.63% | 41.12% | 72.5% | 69.0% |
第 7 步
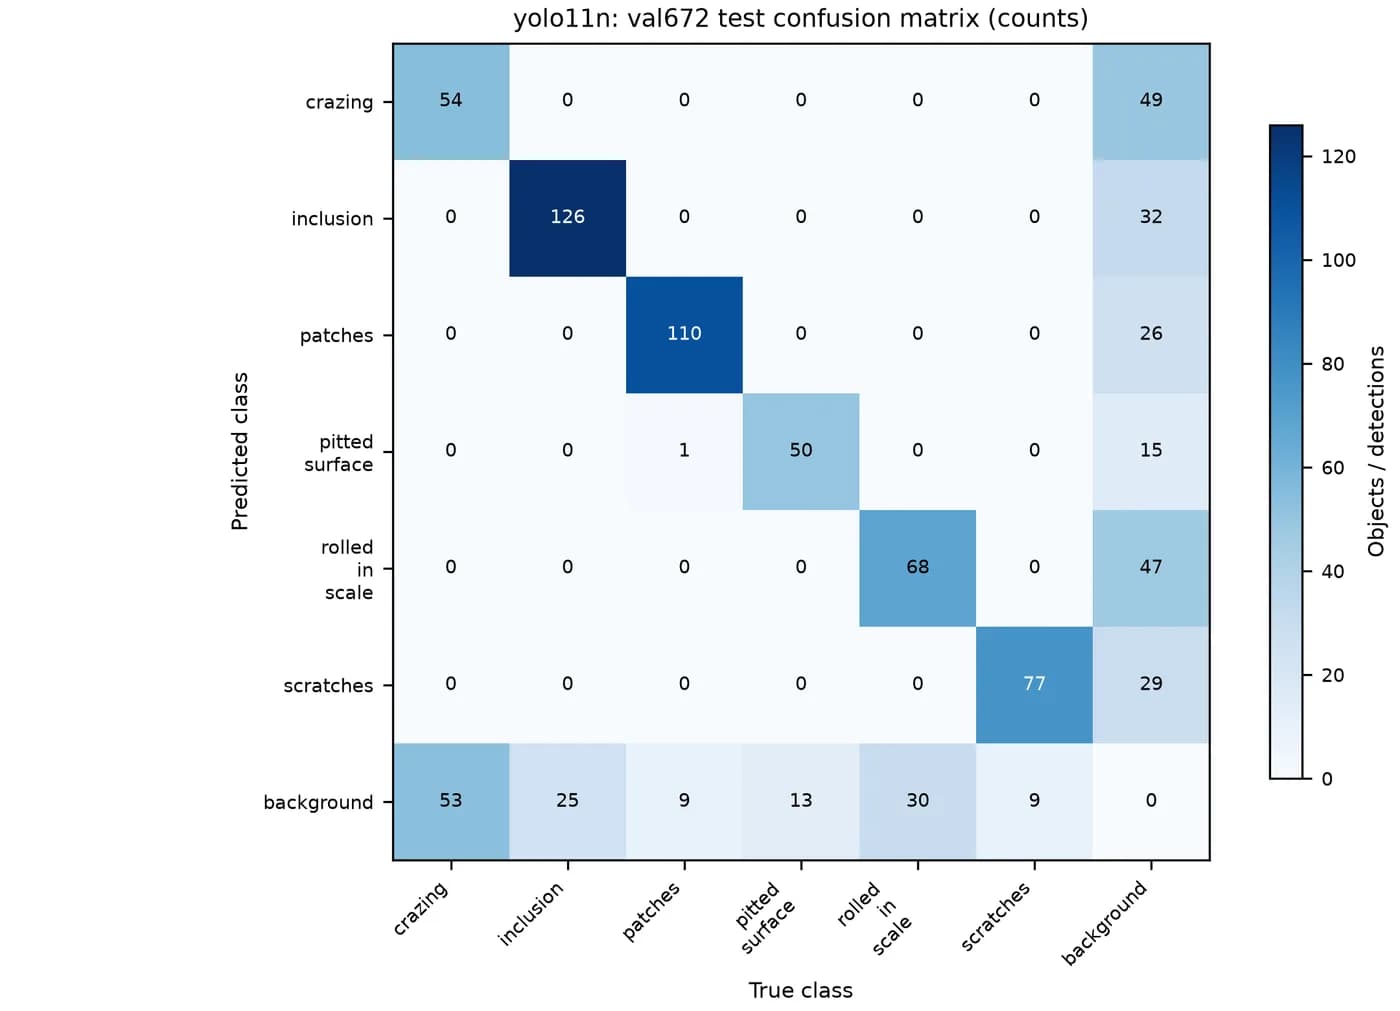
为什么做这一步混淆矩阵告诉你错误是类别判错,还是漏检和误检。
先看坐标轴:这张图横轴是真实类别(True),纵轴是预测类别(Predicted)。对角线是判对的框数。
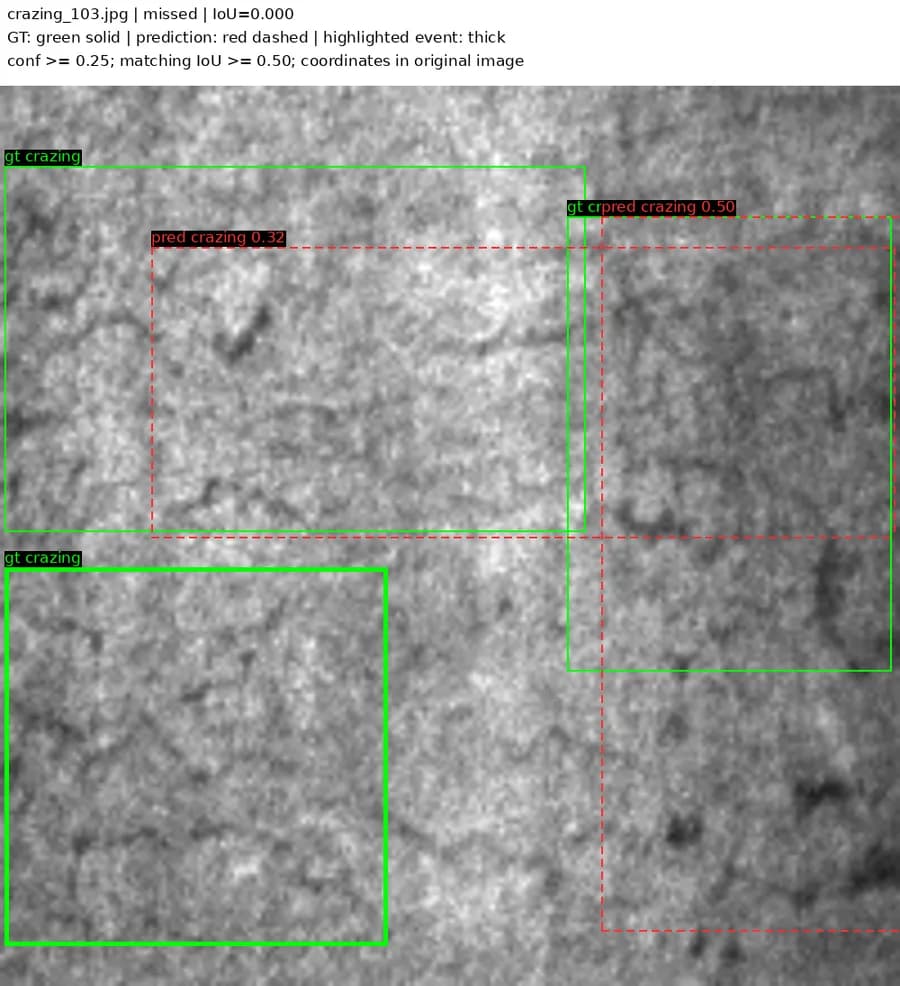
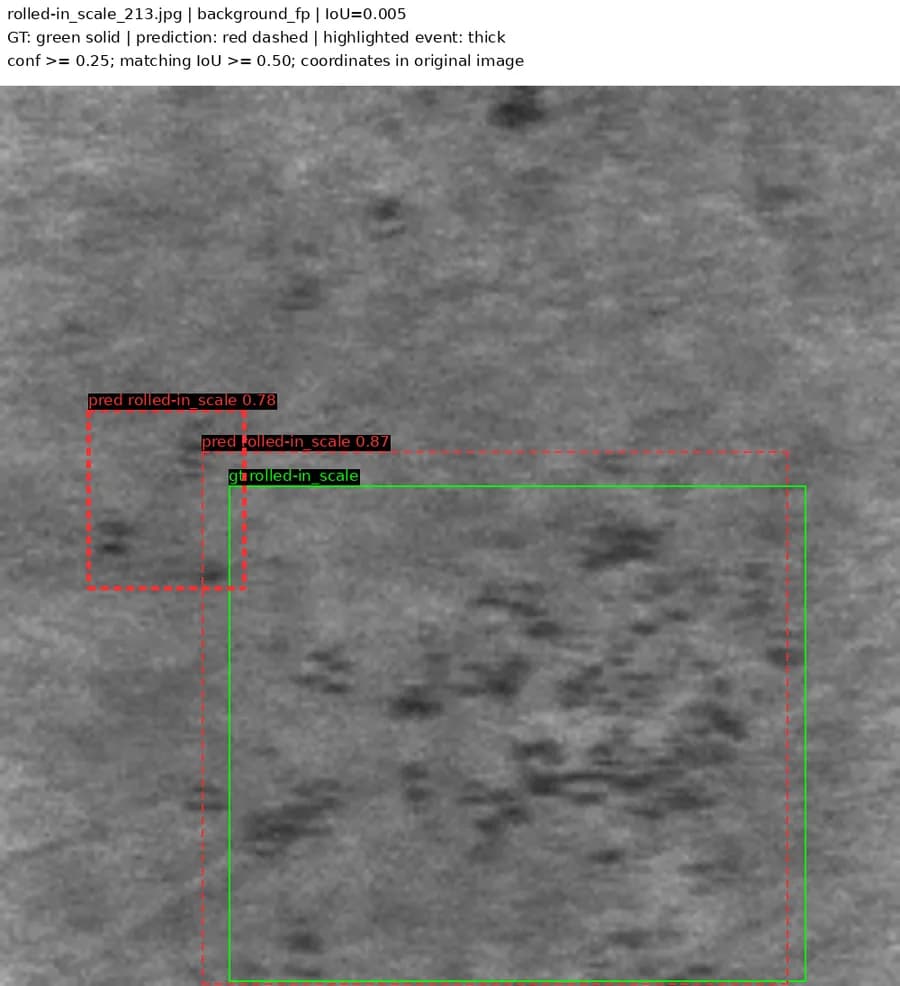
最下面的 background 行是漏检:真实存在、但模型没有报出来的框。龟裂一列有 53 个漏检,只判对 54 个,测试集 107 个龟裂框里漏了一半。最右边的 background 列是误检:模型报了框,但对应位置没有真实缺陷。龟裂行有 49 个误检,压入氧化皮行有 47 个。
六类缺陷之间几乎没有互相判错,只有 1 个斑块被判成麻点。NEU-DET 上的主要问题是缺陷和背景分不开,不是类别之间混淆。
第 8 步
为什么做这一步总 mAP 会掩盖最差类别。逐类 AP 能告诉你下一步该改哪里。
龟裂是细碎的网状纹理,分布在整片区域,标注框的边界很难统一;压入氧化皮与正常氧化层的纹理相近。这两类的 AP50-95 分别只有 14.6% 和 28.6%。想提高总 mAP,优先针对这两类:检查标注一致性,分析漏检样例,再考虑改结构。
| 类别 | YOLO11n AP50 | YOLO11n AP50-95 | 三篇论文 YOLOv8n AP50 |
|---|---|---|---|
| 龟裂 crazing | 43.7% | 14.6% | 38.8%–47.9% |
| 夹杂 inclusion | 85.1% | 41.1% | 82.0%–84.9% |
| 斑块 patches | 93.9% | 64.4% | 88.9%–94.0% |
| 麻点 pitted_surface | 85.3% | 57.7% | 83.3%–84.3% |
| 压入氧化皮 rolled-in_scale | 62.7% | 28.6% | 55.9%–66.9% |
| 划痕 scratches | 89.0% | 50.5% | 92.0%–97.1% |
原理与判断
原理
为什么做这一步解释你的结果与论文、与别人对不上的常见原因。
本次训练写的是 imgsz=640,但 Ultralytics 的 val 默认使用矩形推理(rect=True),200×200 的图实际被处理成 672×672。用 predict 在 640×640 下保存预测、再计算 AP,得到的结果不同。
在 640 方式下:YOLO11n mAP50 为 74.29%,YOLO11s 74.03%,YOLOv8n 70.52%,YOLOv8s 69.53%。在 val 默认方式下 YOLOv8n 排第一,在 640 方式下 YOLO11n 排第一。同一批权重,评估方式不同,排名就会变化。
这个差异由独立审阅发现,报告中两套结果分开列出。和论文比较时,至少要对齐划分方式、输入尺寸、轮数、预训练权重、软件版本以及是 val 还是 test 上的结果。
| 论文 | 划分 | YOLOv8n mAP50 |
|---|---|---|
| FP-YOLOv8(Sensors 2024) | 训练/验证 7:3 | 74.8% |
| DDI-YOLO(Applied Sciences 2024) | 1440/180/180 | 75.9% |
| YOLO-SDS(Sensors 2024) | 9:1,1620/180 | 76.2% |
| DSL-YOLO(Sensors 2024) | 8:1:1,1440/180/180 | 76.4% |
| Regularized YOLO(Sensors 2024) | 训练/验证 8:2 | 78.4% |
| 本页(val 默认方式) | 1260/270/270,测试集 | 77.1% |
按你的情况选择
选择
为什么做这一步按精度、速度和模型大小选模型。
在 NEU-DET 这种 1,800 张图的小数据集上,s 版本没有比 n 版本更准,CPU 推理却慢 2–3 倍。数据量小时先用 n 版本做基线;YOLO11n 参数更少,mAP50-95 略高。数据量更大或目标更小时,再试 s 及以上规模。
| 模型 | 参数量 | GFLOPs | 权重大小 | T4 单图耗时 | CPU 单图耗时 |
|---|---|---|---|---|---|
| YOLO11n | 2.61M | 6.6 | 5.5 MB | 9.7 ms | 166 ms |
| YOLOv8n | 3.14M | 8.8 | 6.5 MB | 8.0 ms | 166 ms |
| YOLO11s | 9.43M | 21.7 | 19.2 MB | 10.8 ms | 382 ms |
| YOLOv8s | 11.14M | 28.7 | 22.5 MB | 11.0 ms | 480 ms |
参考与附录
运行记录
为什么做这一步说明数据来源与运行条件,方便你复核。
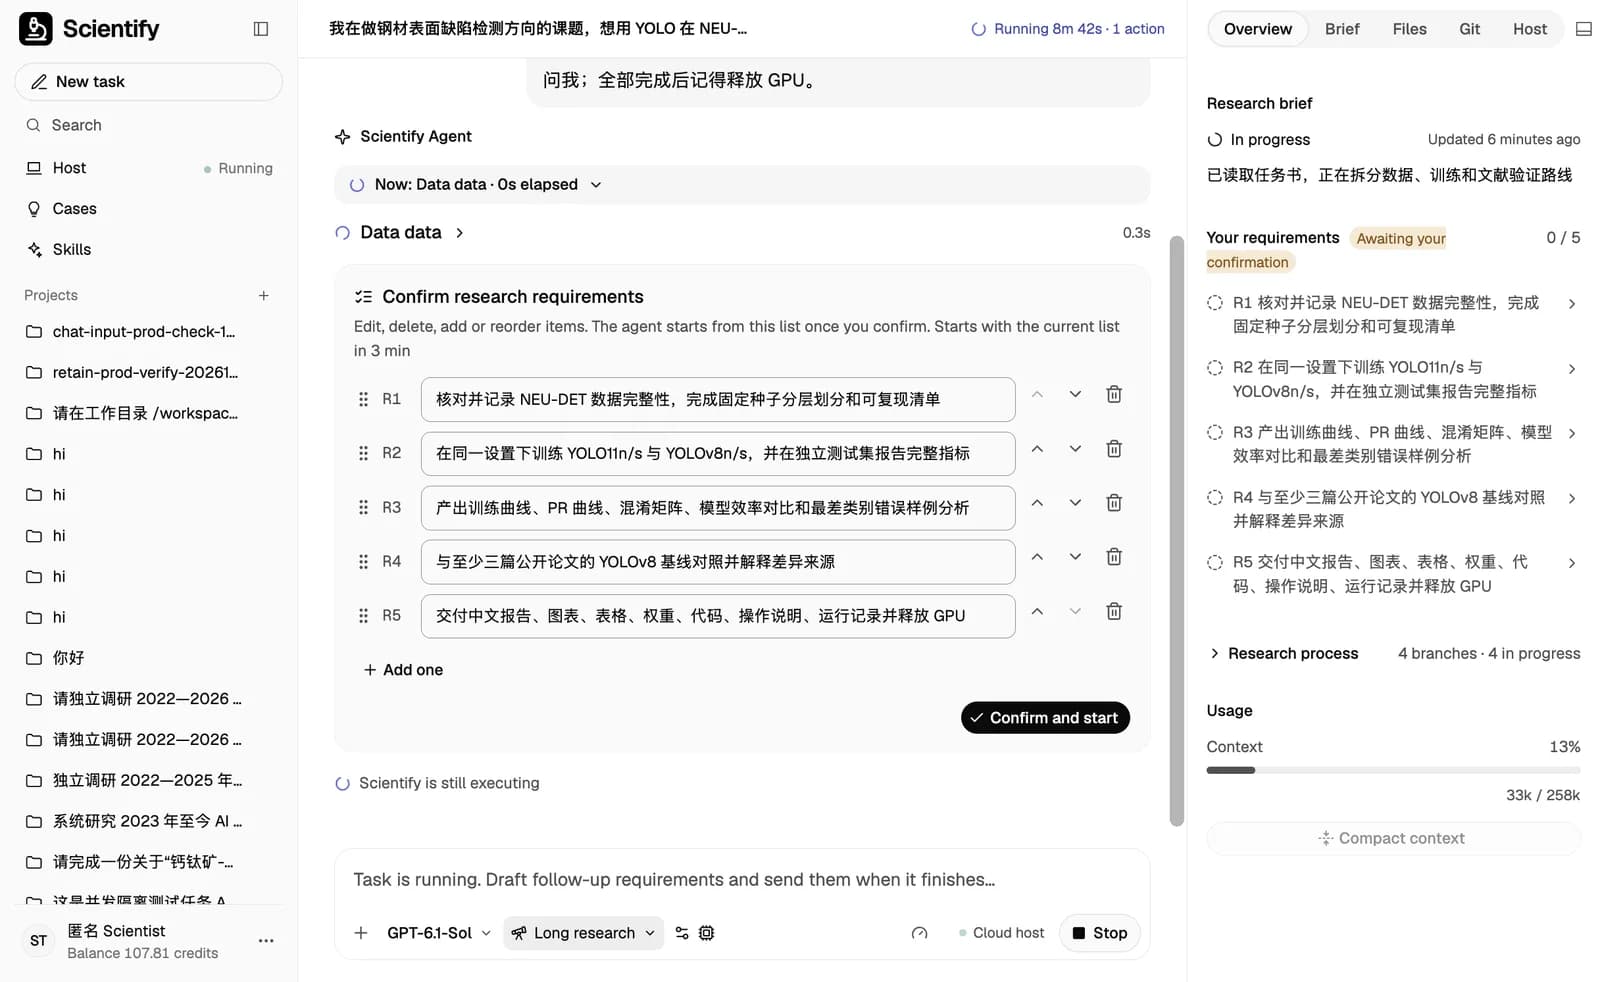
本页的全部数字来自 2026 年 10 月 27 日在 Scientify 上的一次长周期研究任务。用户上传任务书后,Scientify 列出 5 条研究要求供确认,随后自行下载数据、核对重复图像、租用一块 T4 GPU 依次训练四个模型,训练结果同步回工作区后释放 GPU,再写出 35 页中文报告。
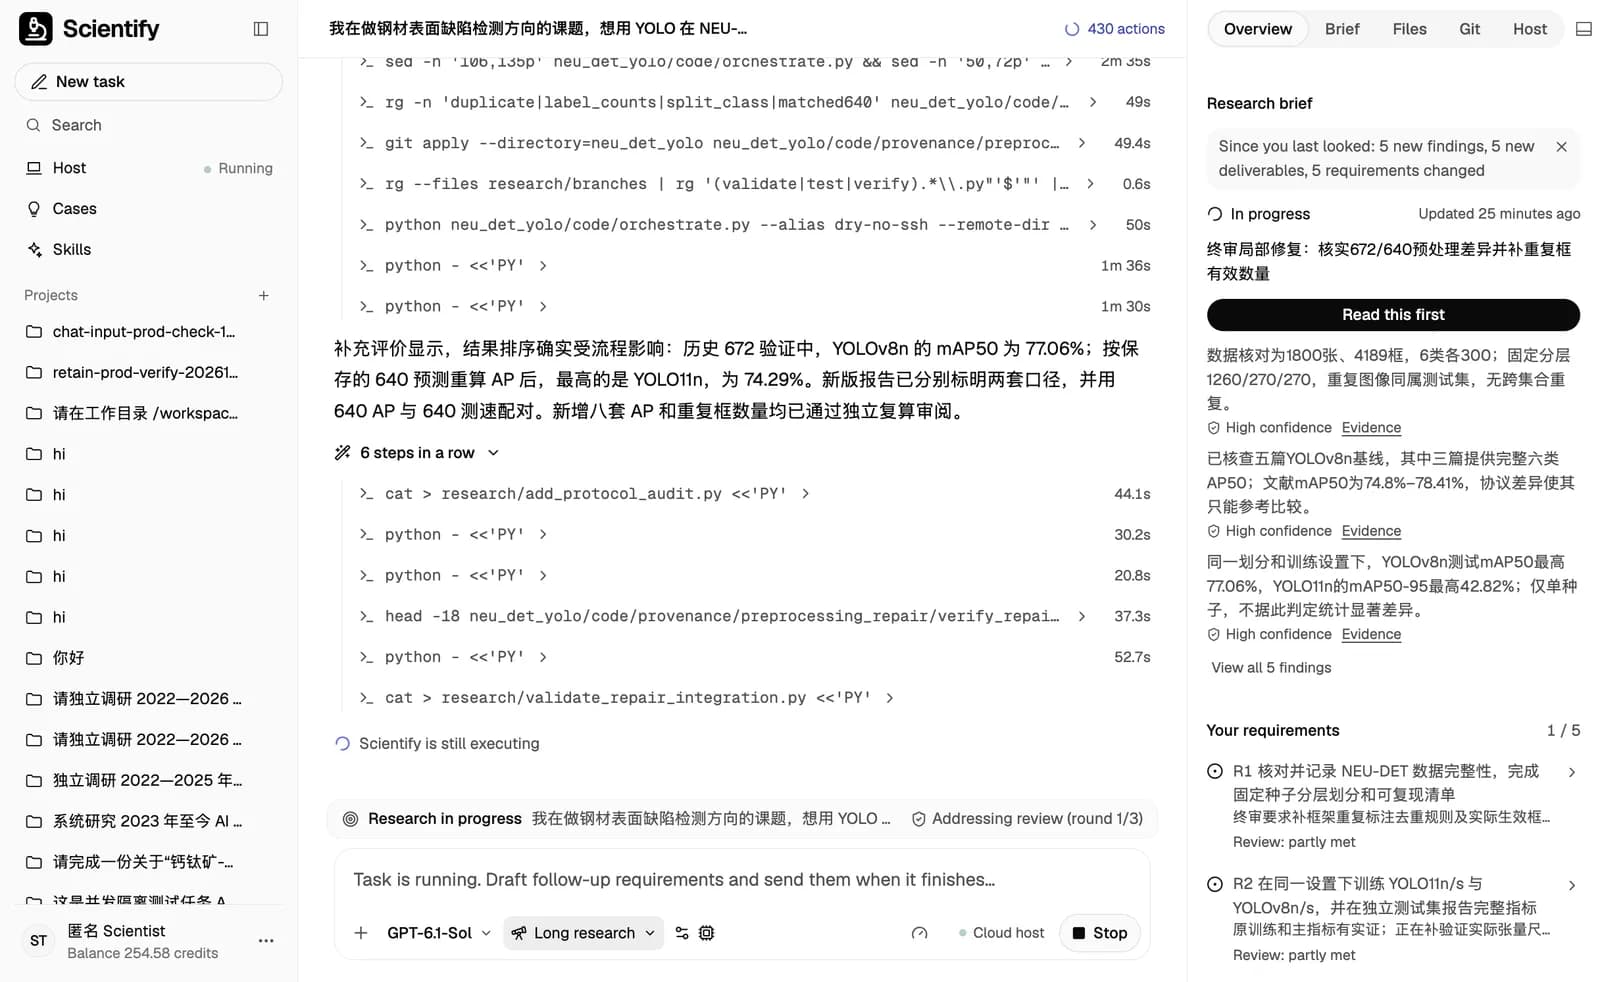
第一版报告完成后,独立审阅指出验证与测速使用的输入尺寸不一致(672 与 640)。Scientify 补做了 640 方式的完整复算,把结论从“YOLOv8n 最好”改为“排名取决于评估方式”,第二次审阅通过。全程约 5 小时,其中 GPU 使用约 3 小时。
常见报错与处理
按出现频率排序。
Dataset images not found / FileNotFoundError
原因:data.yaml 的 path 是相对路径或本机路径,到服务器上找不到;或大小写、扩展名不一致。
怎么解决:在训练机器上重新生成使用绝对路径的 data.yaml,并检查 images/train 等目录确实存在。
No labels found,或 background 数量异常多
原因:labels 目录与 images 不是镜像结构,或直接把 XML 交给了 YOLO。
怎么解决:确认每张图在 labels 下有同名 TXT 且非空;先完成 VOC 转 YOLO。
non-normalized or out of bounds coordinates
原因:TXT 里写了像素坐标,或把 COCO 的 xywh 当成 VOC 的 xyxy 计算。
怎么解决:按原图宽高重新归一化;不要全量裁剪越界框,先查出错的原始标注。
Label class exceeds dataset class count
原因:类别 ID 没有从 0 开始,或 names 顺序与转换时不一致。
怎么解决:统一一份类别映射表,转换和 data.yaml 都用它。
标签改过了,统计数字还是旧的
原因:YOLO 缓存了上次扫描结果。
怎么解决:删除 labels 旁边的 .cache 文件后重新训练。
CUDA out of memory
原因:batch 过大或有其他进程占用显存。
怎么解决:先用 nvidia-smi 查占用;仍不够时减小 batch,对比实验中所有模型一起改。
torch.cuda.is_available() 为 False
原因:装的是 CPU 版 PyTorch,或运行的不是装了 GPU 版的那个 Python。
怎么解决:用 which python 与 pip show torch 确认环境,再安装与驱动匹配的 GPU 版本。
loss 为 nan 或 mAP 一直为 0
原因:标签坐标或类别错误、没有加载预训练权重、学习率过大。
怎么解决:先抽图叠框检查标签,确认 model=*.pt,再看学习率与 AMP;增加轮数解决不了这类问题。
参考资料
- Ultralytics 训练模式与参数
- Ultralytics 验证模式与指标
- Ultralytics 检测数据集格式
- NEU-DET,IEEE DataPort — 数据集说明与下载
- FP-YOLOv8,Sensors 2024 — YOLOv8n 基线 mAP50 74.8%
- YOLO-SDS,Sensors 2024 — YOLOv8n 基线 76.2%,含六类 AP50
- DSL-YOLO,Sensors 2024 — YOLOv8n 基线 76.4%
- DDI-YOLO,Applied Sciences 2024 — YOLOv8n 基线 75.9%,含六类 AP50
- Regularized YOLO,Sensors 2024 — YOLOv8n 基线 78.41%,含六类 AP50