 Scientify
本页说明
操作指南- 这页解决什么
- 你要用 VOSviewer 画关键词共现图或共被引图,但不确定去哪里下载、知网数据能不能用、阈值和聚类参数怎么设。
- 适合谁
- 第一次做文献计量的研究生,以及需要在论文中写清 VOSviewer 参数的作者。
- 读完你会得到
- 读完能独立完成一张关键词共现图,写出参数设置,并能解释聚类数量为什么会随参数变化。
- 覆盖
- 官网、版本、Java 要求和网页版
- WoS、Scopus、OpenAlex 和知网数据的导入方式
- 最小出现次数、同义词表和 association strength 标准化
- 聚类分辨率对聚类数量的影响,附实测结果
- map 和 network 文件格式,附可下载文件
- 不覆盖
- 关键词突现分析(VOSviewer 不支持,见 CiteSpace 教程)
- VOSviewer 菜单的逐项截图说明
- 检索式的完整写法
主线步骤
第 1 步
为什么做这一步确认版本和 Java 环境,避免打不开或内存不足。
VOSviewer 官网是 vosviewer.com,下载页提供三种文件:Windows 可执行程序包、macOS 应用程序包,以及用于其他系统的 JAR 文件。官网说明软件可以免费用于任何用途,下载不需要注册。
VOSviewer 是 Java 程序,需要 Java 8 或更高版本,Oracle Java 和 Eclipse Temurin 等 OpenJDK 发行版都可以。网络较大时会出现内存不足,可以用命令行启动并提高内存上限。
官网下载的版本是英文界面。网上的“VOSviewer 中文版”多为第三方修改的安装包,来源无法核实,不建议使用。
java -Xmx4000m -jar VOSviewer.jarjava -jar VOSviewer.jar -map keywords_map.txt -network keywords_network.txt| 项目 | 内容 |
|---|---|
| 最新版本 | 1.6.21(2026-06-12) |
| 价格 | 免费,可用于任何用途 |
| 运行环境 | Java 8 或更高版本 |
| 安装包 | Windows、macOS、JAR(其他系统) |
| 网页版 | app.vosviewer.com,可打开 map/network 文件和 JSON 文件 |
第 2 步
为什么做这一步不同数据源对应不同的读取入口,能做的分析也不同。
在 VOSviewer 中点 Create,选择 Create a map based on bibliographic data,再按数据来源选择读取方式。Web of Science 导出纯文本或制表符分隔文件,记录内容选“全记录与引用的参考文献”。Scopus 导出 CSV,勾选全部字段和参考文献。
官网更新记录显示,VOSviewer 1.6.18 起可以基于 OpenAlex 数据建图,1.6.17 起支持 Lens 导出文件,1.6.20 起支持 Scopus 新导出格式。
知网(CNKI)没有专门的读取入口。常用做法是从知网导出 RefWorks 或 EndNote 格式,在 VOSviewer 中选择读取文献管理软件文件(reference manager files),用关键词字段做共现。VOSviewer 从标题和摘要中提取术语的文本挖掘功能只支持英文,中文标题摘要不能用这个功能。知网记录没有可用的参考文献字段,不能做共被引。
| 数据源 | 导出格式 | 能做的分析 |
|---|---|---|
| Web of Science | 纯文本或制表符分隔,全记录与引用的参考文献 | 全部 |
| Scopus | CSV,含全部字段与参考文献 | 全部 |
| OpenAlex | VOSviewer 1.6.18 起支持 | 共现、引文与合作 |
| 知网 CNKI | RefWorks 或 EndNote | 关键词共现、作者合作;不能做共被引与中文文本挖掘 |
第 3 步
为什么做这一步这一步决定图中保留哪些关键词,以及同一概念的不同写法是否合并。
分析类型选 Co-occurrence,分析单元选 All keywords(作者关键词与数据库补充关键词)或 Author keywords。计数方式选 Full counting 时,一篇文献中出现的每对关键词都计一次;Fractional counting 会按文献的关键词数量分摊权重。
最小出现次数(Minimum number of occurrences)决定哪些关键词留在图中。阈值越高,小主题被删除;阈值越低,图越拥挤。实测任务中,6,676 个不同关键词里有 491 个出现至少 5 次,最终按频次保留前 150 个(出现至少 13 次)。论文中要写明阈值和筛选前后的关键词数。
同义词表(thesaurus)用来合并单复数、缩写和不同拼写,例如 LLM、large language model、large language models。文件是制表符分隔的两列文本,第一行是表头 label 和 replace by。多义词不要机械合并,例如 GPT-4 和 large language model 不是同一个概念。
label	replace by
llm	large language model
llms	large language model
large language models	large language model
chat-gpt chatgpt第 4 步
为什么做这一步聚类数量主要由分辨率(resolution)决定,报告聚类结果时要写明这个参数。
VOSviewer 的聚类参数有分辨率、最小聚类规模和是否合并小聚类。分辨率越高,聚类越多、越小。网页版的默认设置是分辨率 1、最小聚类规模 1,并合并小聚类。
我们把实测任务的 150 个关键词网络导入 VOSviewer 网页版,保持其他参数为默认值,只改变分辨率,重新运行 VOSviewer 自带的聚类。分辨率从 0.5 增加到 2,聚类数从 2 个增加到 22 个。同一份数据可以得到 2 到 22 个“研究主题”,所以论文中报告的聚类数需要同时写分辨率,并说明为什么选这个值。
实测任务用 Python 的 Louvain 算法在分辨率 1 下得到 4 个聚类,VOSviewer 自带算法在相同分辨率下得到 6 个。两者的目标函数和标准化方式不同,结果不会完全一致。
| 分辨率 | 0.5 | 0.75 | 1(默认) | 1.5 | 2 |
|---|---|---|---|---|---|
| VOSviewer 聚类数 | 2 | 3 | 6 | 11 | 22 |
- 论文中写明分辨率、最小聚类规模和是否合并小聚类
- 比较相邻两三个分辨率下的聚类是否稳定
- 用每个聚类的高频词和代表文献命名聚类,不只看颜色
第 5 步
为什么做这一步map 和 network 文件可以在不同电脑和网页版之间交换结果,也能把 Python 或 R 的分析结果导入 VOSviewer。
VOSviewer 网页版地址是 app.vosviewer.com,不需要安装。点右上角的 Open,文件类型选 VOSviewer map and network file,分别选择 map 文件和 network 文件,点 OK 即可打开。网页版也可以重新计算布局和聚类。
map 文件是制表符分隔的文本,第一行为表头,常用列为 id、label、weight<Occurrences>、cluster,可选 x、y 坐标。没有坐标时 VOSviewer 会自动布局。network 文件没有表头,每行三列:起点 id、终点 id、连线强度。
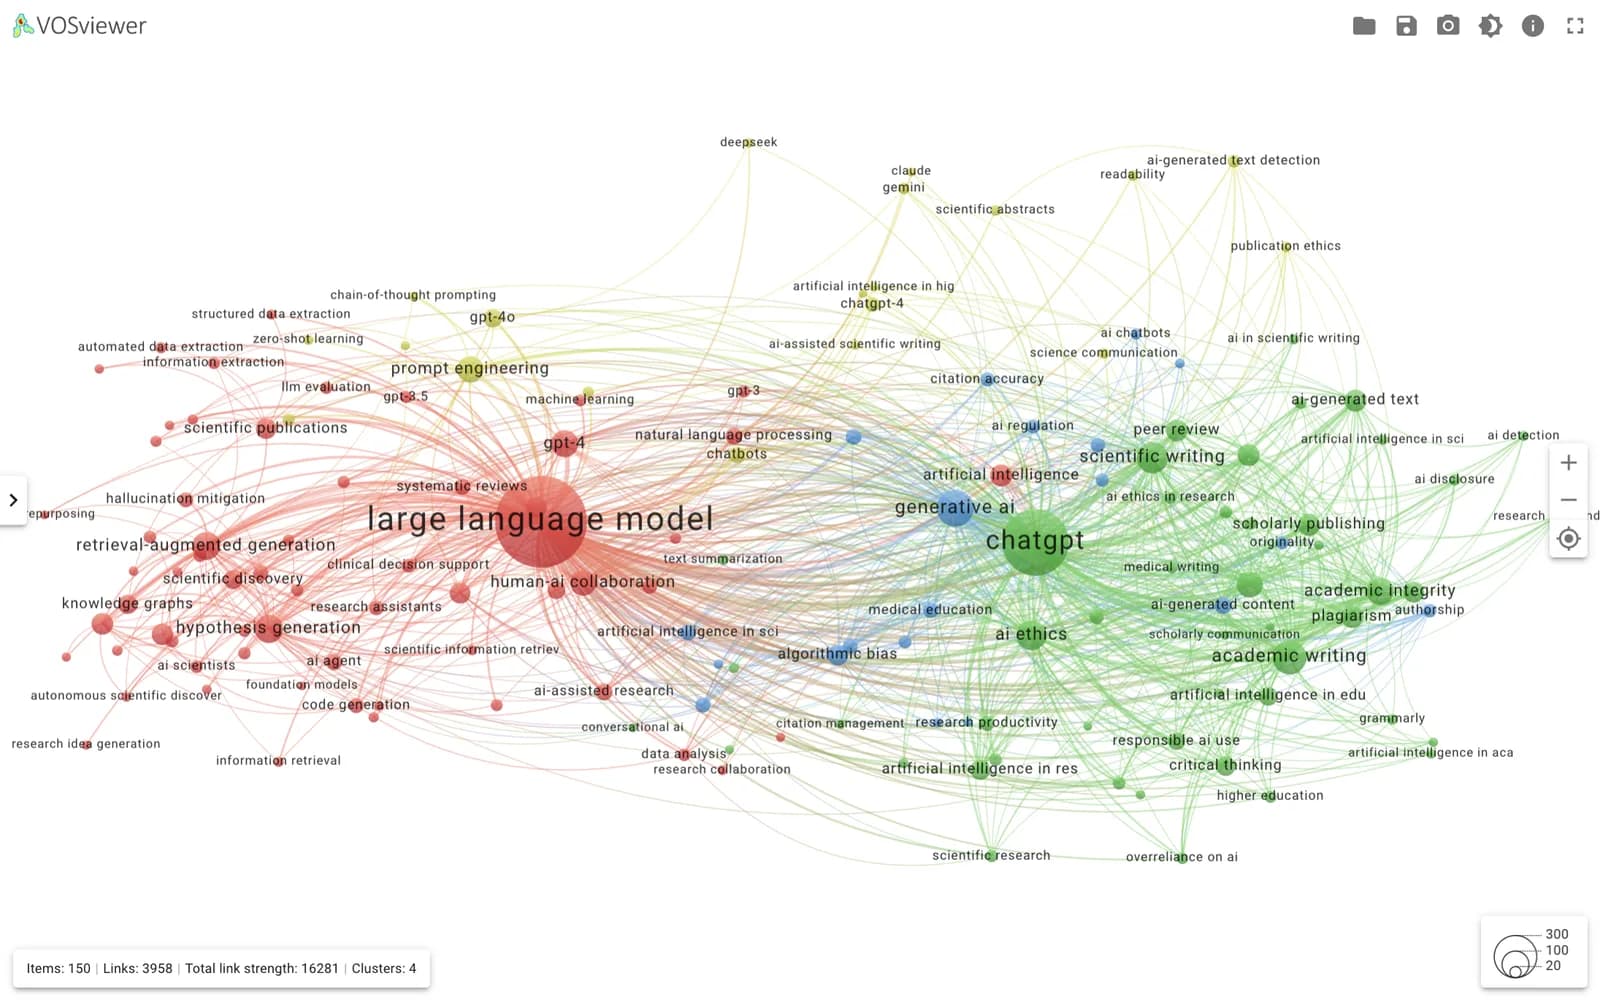
下面四个文件来自实测任务,在 VOSviewer 网页版中实测打开:关键词共现网络为 150 个节点、3,958 条连线、4 个聚类;文献共被引网络为 200 个节点、7,765 条连线、2 个聚类。下载后可以直接打开,对照本页的参数做练习。
id	label	weight<Occurrences>	cluster
1	large language model	1421.0	1
2	chatgpt	750.0	2
3 generative ai 230.0 31 2 396.0
1 3 103.0
1 4 101.0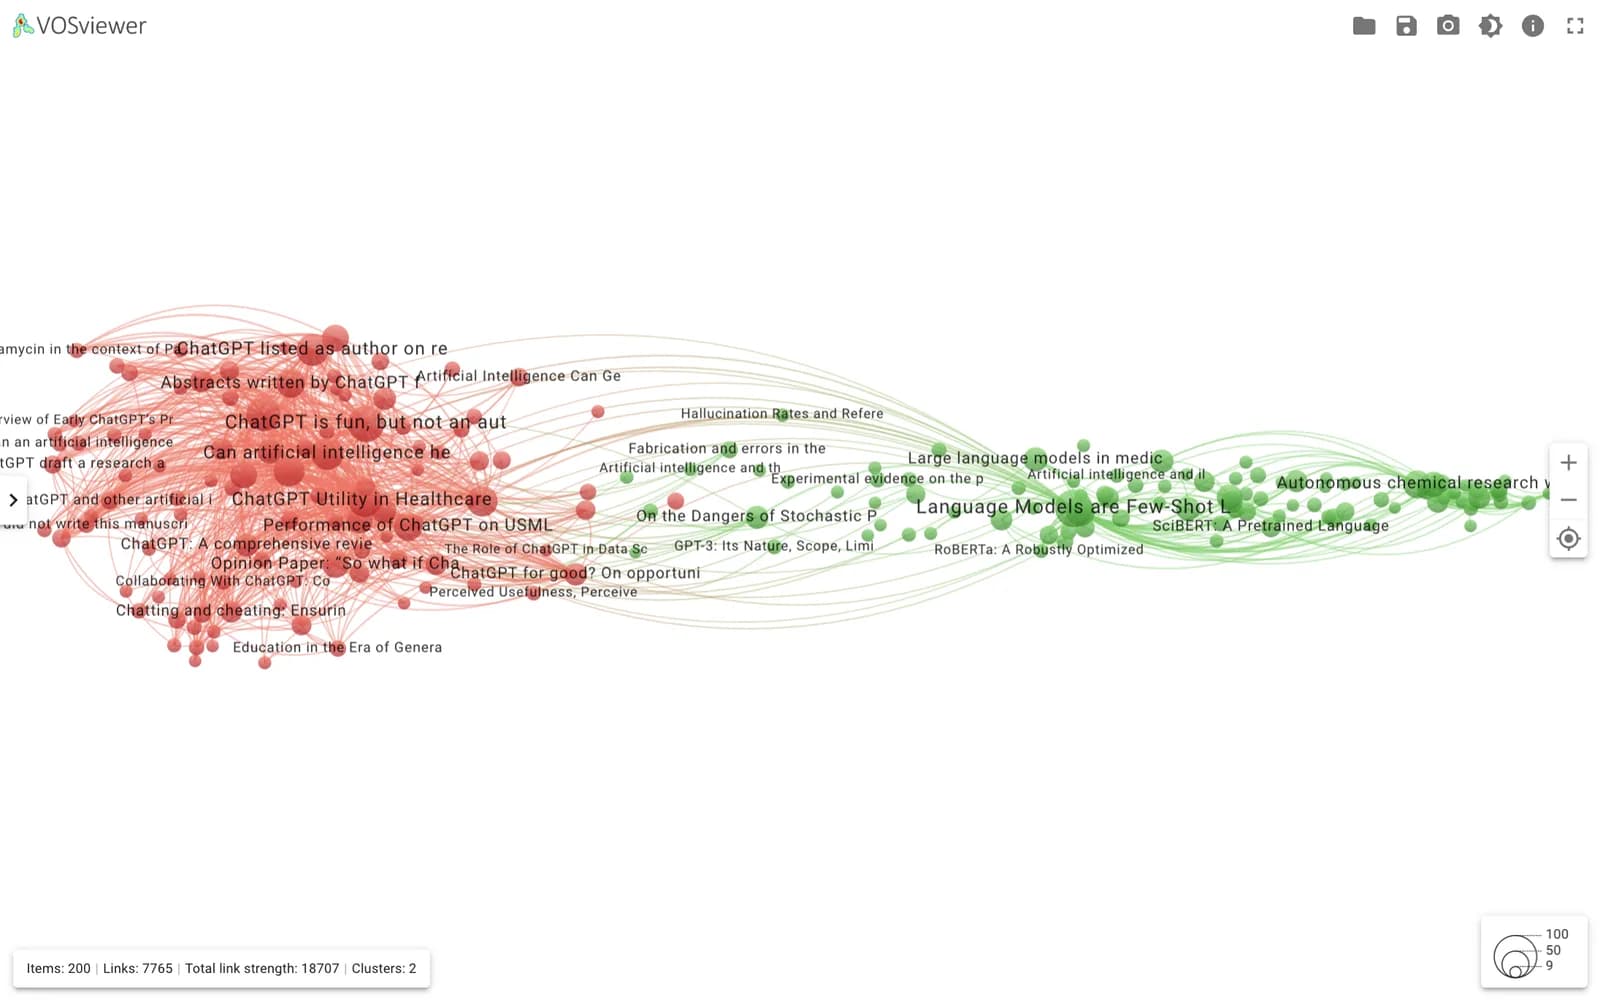
参考与附录
运行记录
为什么做这一步说明数据来源、分析方法和验证范围。
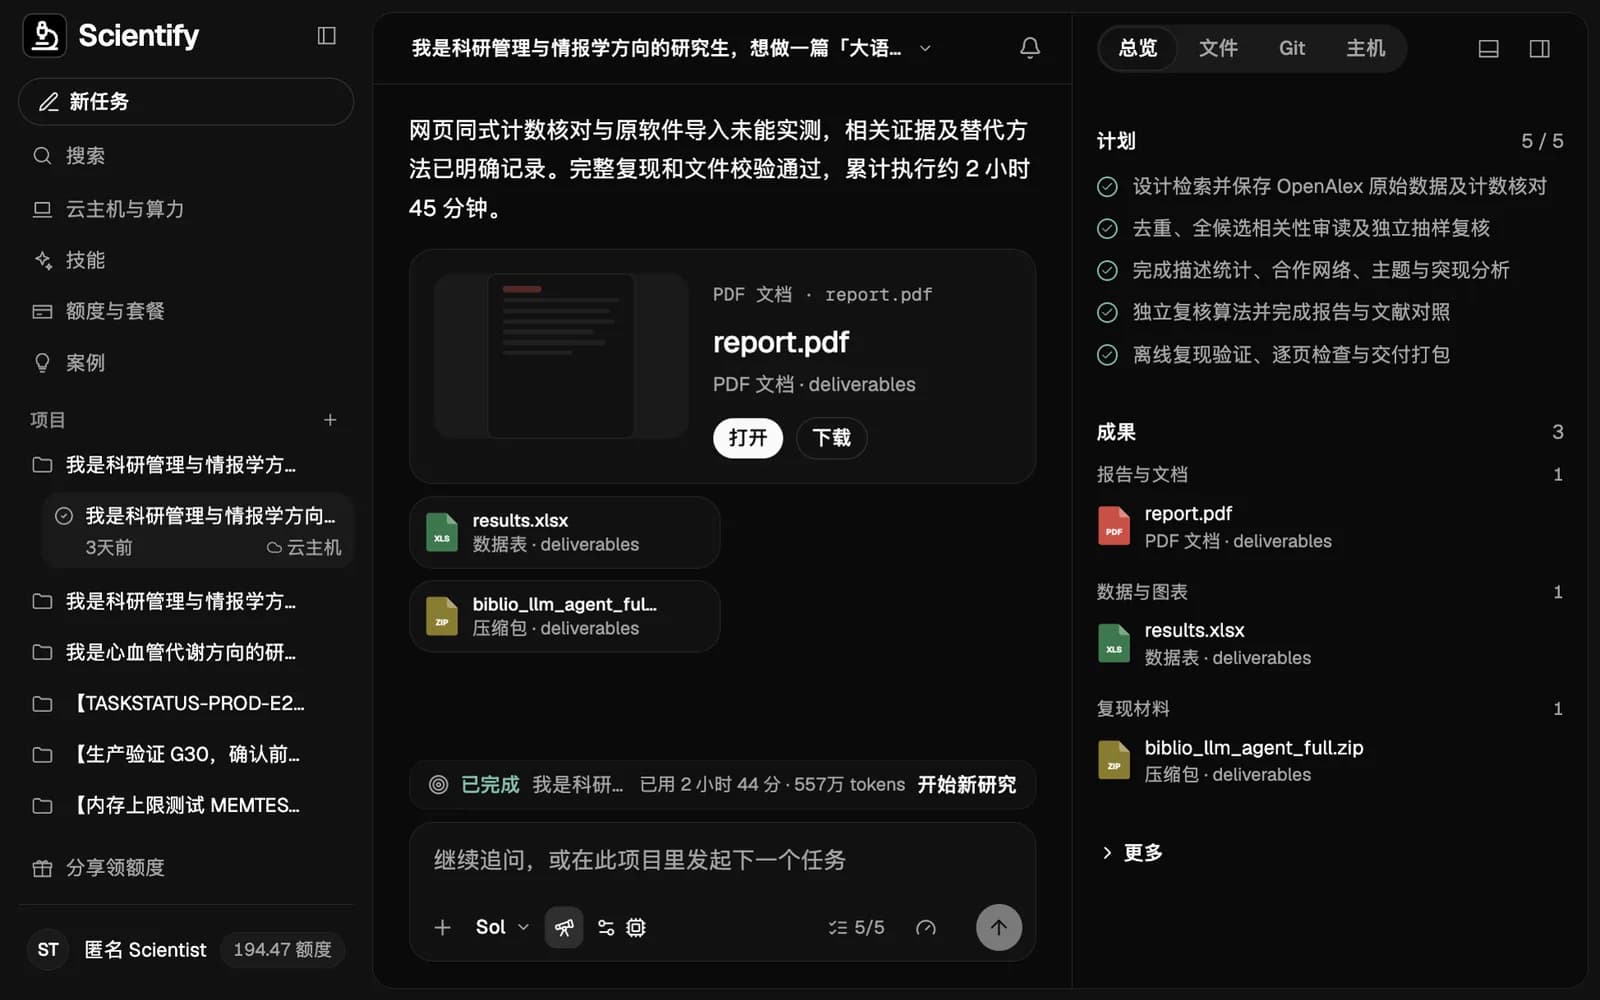
网络文件来自 2026 年 10 月 30 日至 11 月 2 日在 Scientify 上的一次长周期研究任务,题目是 2020–2025 年大语言模型与 AI 智能体在科学研究中的应用。数据来自 OpenAlex API,Scientify 对 3,297 篇候选逐篇阅读题名和摘要,最终纳入 2,120 篇,独立抽查 50 篇中 49 篇相关。
任务运行时 VOSviewer 官网连接超时,云电脑没有取得安装包。Scientify 用 Python 完成共现、association strength 标准化和 Louvain 聚类,并按 VOSviewer 文件格式导出 map 和 network 文件。2026 年 11 月 3 日,我们在 VOSviewer 网页版中打开这些文件并完成了上面的分辨率测试。关键词突现等分析结果见 CiteSpace 使用教程。
常见问题排查
双击 JAR 没有反应,或提示找不到 Java
原因:没有安装 Java 8 或更高版本。
怎么解决:安装 Eclipse Temurin 等 OpenJDK 发行版,在终端运行 java -version 确认后再启动。
数据量大时卡死或提示内存不足
原因:默认 Java 内存上限不够。
怎么解决:用 java -Xmx4000m -jar VOSviewer.jar 启动,把内存上限提高到 4 GB。
知网数据做文本挖掘时提取不到中文术语
原因:VOSviewer 的文本挖掘只支持英文。
怎么解决:改用关键词字段做共现分析,或先在 Python、R 中分词后生成 map 和 network 文件再导入。
聚类太多、很多聚类只有几个词
原因:分辨率偏高,或最小聚类规模过小。
怎么解决:降低分辨率,或提高最小聚类规模并勾选合并小聚类。实测中分辨率从 1 降到 0.75,聚类从 6 个变为 3 个。
同一个概念出现多个节点,例如 llm 和 large language models
原因:没有加载同义词表。
怎么解决:建立两列的 thesaurus 文件,在选择关键词前加载,再重新生成图。
参考资料
- VOSviewer 官网下载页 — 版本、许可与 Java 要求,2026-11-03 访问
- VOSviewer 官网更新记录 — OpenAlex、Lens、Scopus 新格式支持
- VOSviewer 网页版文档 — 支持的文件类型与 Open 按钮
- van Eck & Waltman, Software survey: VOSviewer, Scientometrics 2010