 Scientify
本页说明
教程- 这页解决什么
- 你的政策在不同年份落地到不同地区,审稿人要求你不要只报双向固定效应的结果。你不知道怎么做 Bacon 分解,怎么用 Callaway–Sant'Anna 估计,也不知道它们和 TWFE 的差别要不要紧。
- 适合谁
- 做政策评估的经管、公共管理和公共卫生方向研究生。熟悉两期两组的 DID,会用 R 或愿意学。
- 读完你会得到
- 读完能在自己的面板上跑出 TWFE、Bacon 分解、Callaway–Sant'Anna 总体效应和事件研究图,并判断 TWFE 的结果能不能信。
- 覆盖
- TWFE 基线和聚类标准误
- Goodman-Bacon 分解及三类 2×2 比较的权重
- Callaway–Sant'Anna 的 ATT(g,t)、总体效应和事件研究
- Sun–Abraham 和插补估计的交叉验证
- 平行趋势检验、HonestDiD 敏感性分析和置换检验
- 计算值与论文、官方文档的对照
- 不覆盖
- Stata 命令的逐行用法(只给与 R 包的对应关系)
- 合成控制和合成 DID
- 三重差分
- 连续处理强度的 DID
主线步骤
第 1 步
为什么做这一步交错 DID 的输入是一份面板:每个个体每期一行,外加首次处理年份。先确认每个个体的处理时点和各批次的个体数。
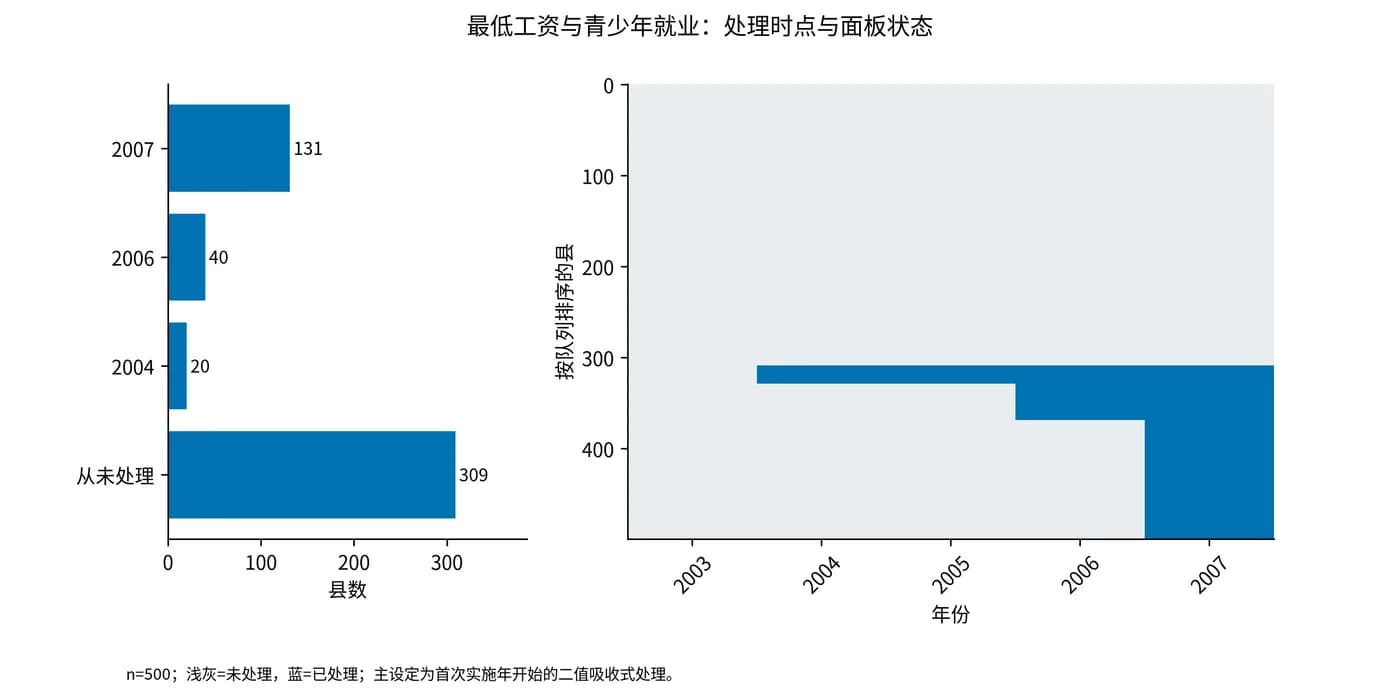
最低工资数据是 R 包 did 自带的 mpdta:500 个县,2003–2007 年,结果变量是青少年就业的对数(lemp)。各县首次提高最低工资的年份是 2004、2006 或 2007,309 个县在样本期内没有提高。did 文档说明它是 Callaway 和 Sant'Anna 论文数据的一个子集。
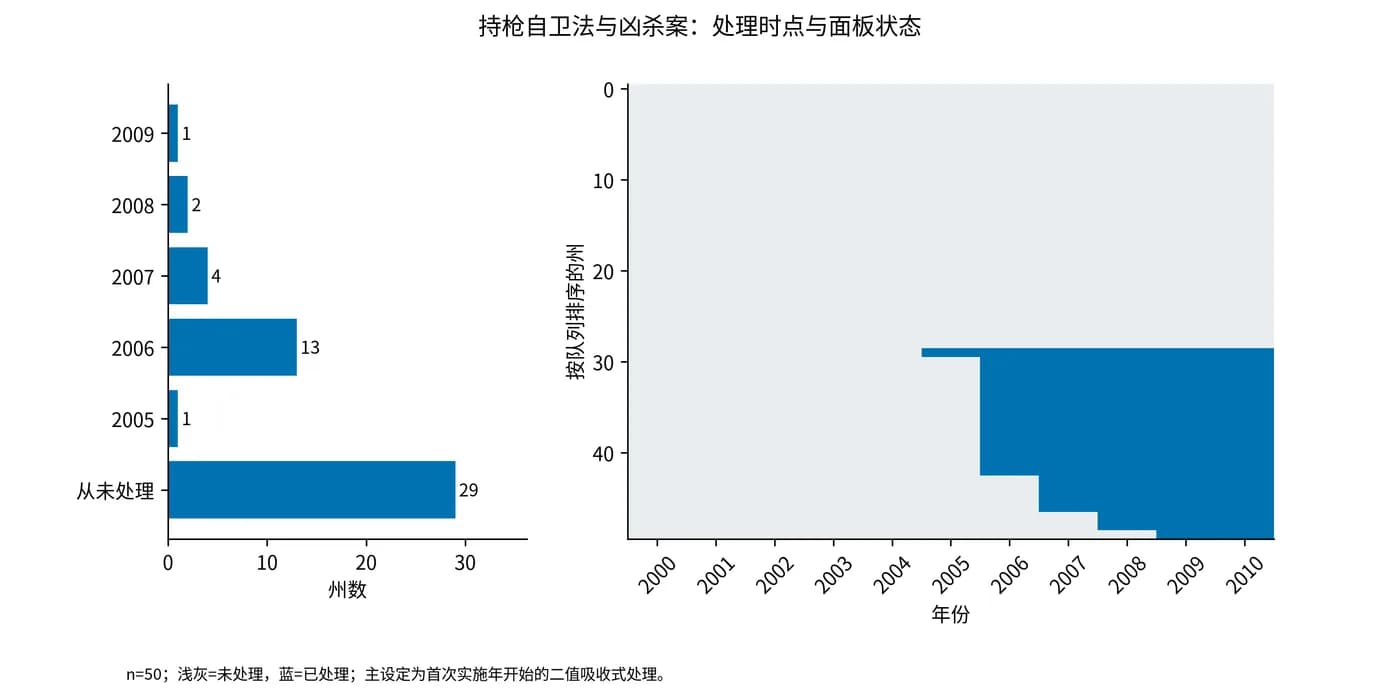
持枪自卫法数据是 Cheng 和 Hoekstra(2013)使用的州级面板:50 个州,2000–2010 年,结果变量是对数凶杀率(l_homicide)。29 个州始终未处理,其余 21 个州分五批在 2005 至 2009 年生效。数据来自 Cunningham 的 Mixtape 仓库。
首次处理年份在 did 包里叫 gname,从未处理的个体记为 0。处理状态 D 在首次处理年份及以后为 1。
library(did); library(fixest); library(bacondecomp)
data(mpdta, package = "did")
d <- mpdta
d$D <- as.integer(d$first.treat > 0 & d$year >= d$first.treat)
table(unique(d[c("countyreal", "first.treat")])$first.treat)| 数据 | 首次处理年份与单位数 | 从未处理 | 合计 |
|---|---|---|---|
| 最低工资(县) | 2004:20;2006:40;2007:131 | 309 | 500 |
| 持枪自卫法(州) | 2005:1;2006:13;2007:4;2008:2;2009:1 | 29 | 50 |
第 2 步
为什么做这一步TWFE 是把处理状态 D 对个体固定效应和时间固定效应回归,审稿人默认你会报告它。后面的每一种估计量都要和它对照。
标准误按个体聚类:mpdta 按县,Castle 按州。最低工资数据的 TWFE 系数是 -0.0365,标准误 0.0133。持枪自卫法数据是 0.0818,标准误 0.0589,95% 置信区间 [-0.037, 0.200]。
因变量是对数,系数约等于百分比变化:-0.0365 约为青少年就业下降 3.6%,0.0818 约为凶杀率上升 8.5%。
twfe <- feols(lemp ~ D | countyreal + year, d, cluster = ~countyreal)
coeftable(twfe)第 3 步
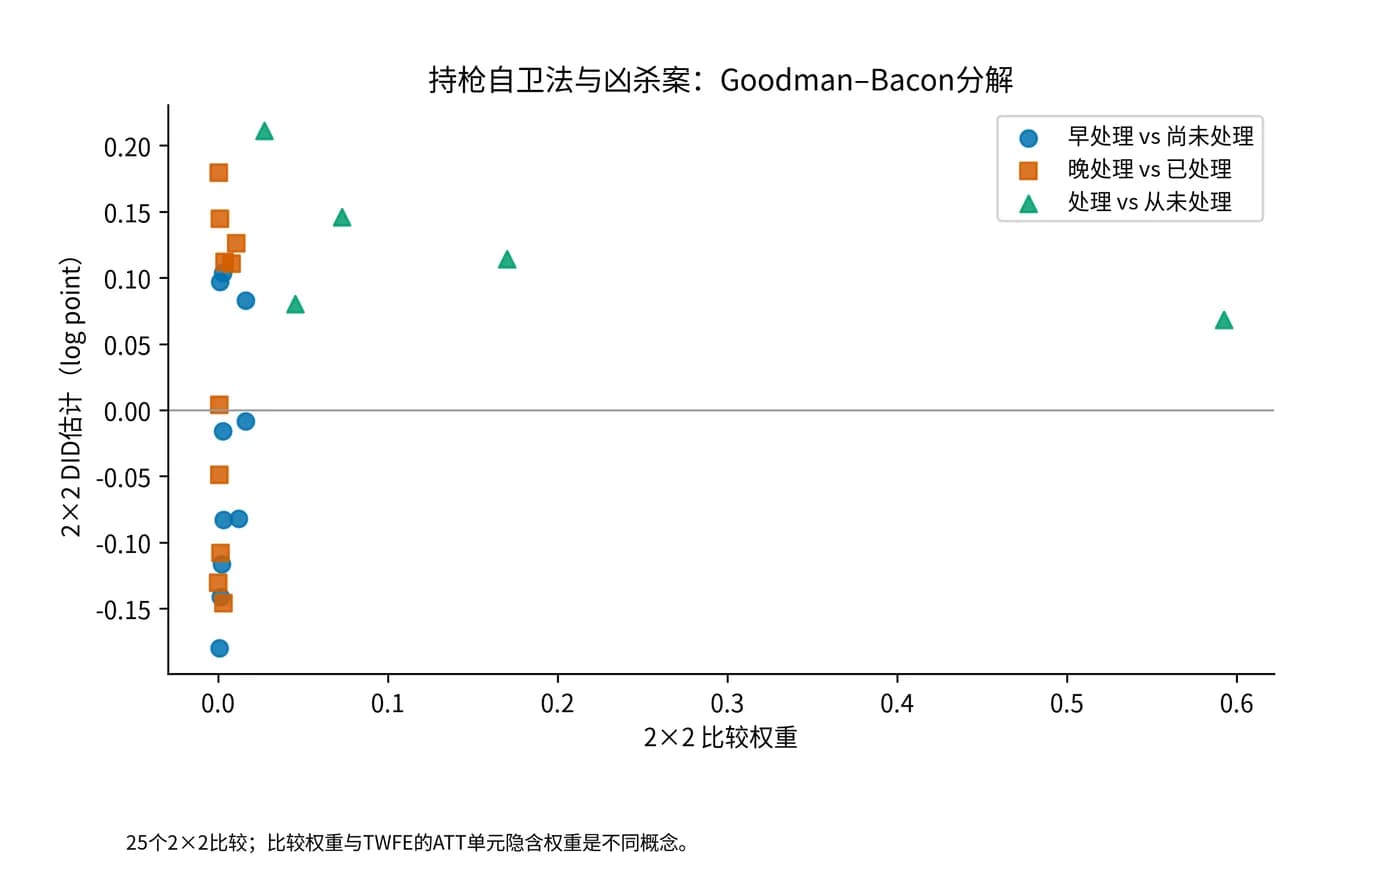
为什么做这一步TWFE 的估计值是所有 2×2 DID 比较的加权平均。Goodman-Bacon 分解把这些比较和权重逐个列出来,让你看到 TWFE 靠哪些比较得到结果。
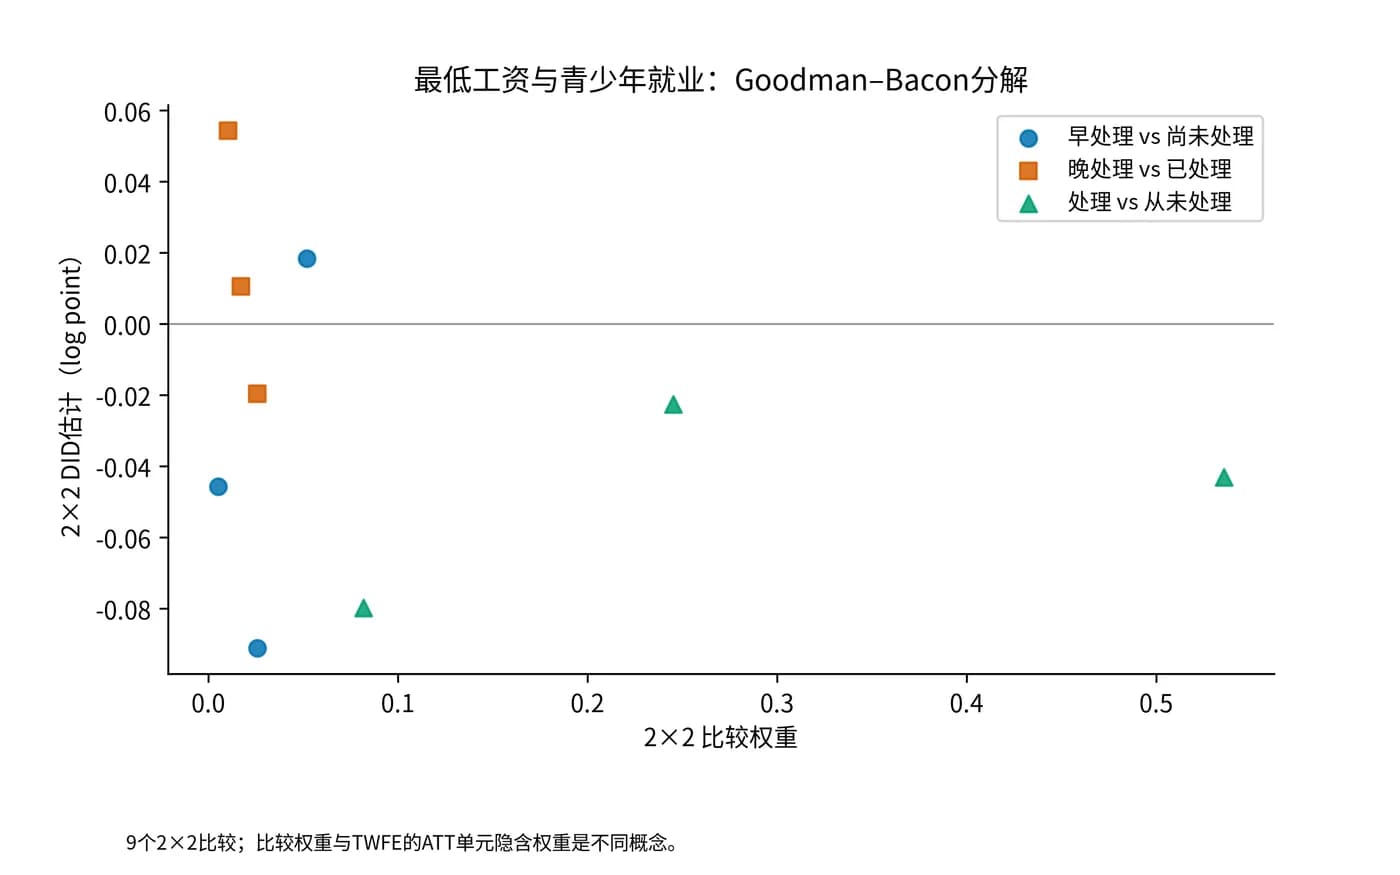
比较分三类:处理组对从未处理组;早处理组对晚处理组,此时晚处理组在自己被处理之前做对照;晚处理组对早处理组,此时已经被处理的早处理组做对照。第三类比较里,对照组自己的效应会进入估计,处理效应随时间变化时这类比较会带来偏误。
两份数据里,处理组对从未处理组的比较权重最大,分别是 86.3% 和 90.8%。已经被处理的组做对照的比较权重较小,分别是 5.4% 和 3.2%。三类权重之和为 1,TWFE 等于权重与各类比较估计值乘积之和。本页运行中这个恒等式的误差小于 10⁻¹⁰。
b <- bacon(lemp ~ D, data = d, id_var = "countyreal", time_var = "year", quietly = TRUE)
types <- do.call(rbind, lapply(split(b, b$type), function(x)
  data.frame(type = x$type[1], weight = sum(x$weight),
estimate = sum(x$weight * x$estimate) / sum(x$weight))))| 比较类型 | mpdta 权重 | mpdta 平均估计值 | Castle 权重 | Castle 平均估计值 |
|---|---|---|---|---|
| 处理组对从未处理组 | 0.8628 | -0.0407 | 0.9083 | 0.0880 |
| 早处理组对晚处理组 | 0.0833 | -0.0198 | 0.0598 | -0.0055 |
| 晚处理组对早处理组(已处理组做对照) | 0.0539 | 0.0046 | 0.0319 | 0.0703 |
第 4 步
为什么做这一步Callaway–Sant'Anna 估计量先估计每个(处理批次 g,时点 t)的平均处理效应 ATT(g,t),每个估计只用没有被处理的个体做对照,再把这些估计汇总。
对照组取从未处理的个体(control_group = "nevertreated")。est_method = "dr" 是 doubly robust,没有协变量时它与 "reg"、"ipw" 的点估计相同。base_period = "universal" 把处理前一期(e = -1)作为所有比较的基准,事件研究图里处理前的系数因此可以直接和 0 比较。置信区间用乘数 bootstrap,999 次,按个体聚类。
最低工资数据有 7 个处理后的 ATT(g,t)。2004 年批次的四个估计是:2004 年 -0.0105,2005 年 -0.0704,2006 年 -0.1373,2007 年 -0.1008。这四个数与 did 官方文档一致。
set.seed(20261106)
gt <- att_gt(yname = "lemp", tname = "year", idname = "countyreal", gname = "first.treat",
             data = d, control_group = "nevertreated", est_method = "dr",
             base_period = "universal", bstrap = TRUE, biters = 999,
             clustervars = "countyreal", cband = TRUE)
summary(gt)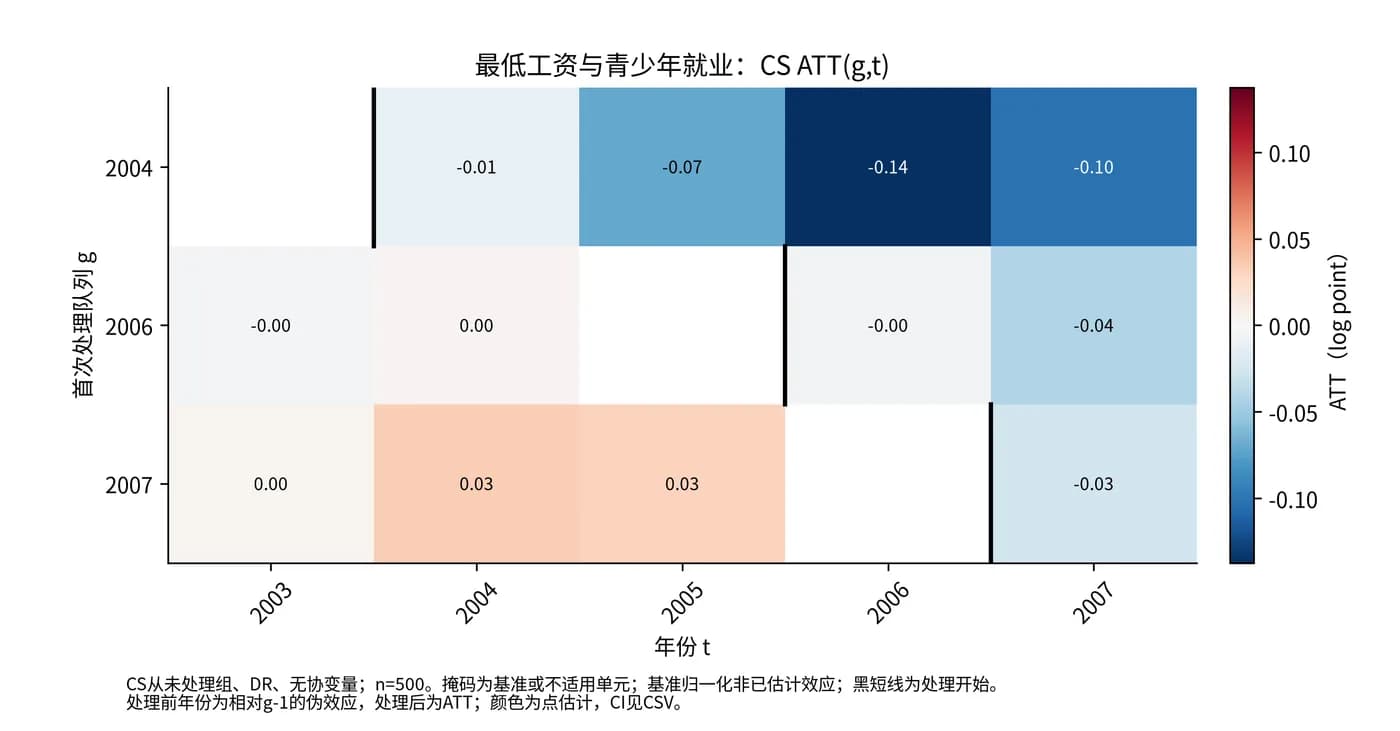
第 5 步
为什么做这一步7 个 ATT(g,t) 还不能直接写进论文,需要汇总。aggte 提供几种汇总方式,每种回答的问题不同。
simple 按批次大小对所有处理后的 ATT(g,t) 加权平均,mpdta 的结果是 -0.0400,标准误 0.0122。dynamic 先按处理后第几年(事件期 e)汇总,再对各事件期取平均:e = 0 到 3 分别是 -0.0199、-0.0510、-0.1373、-0.1008,平均为 -0.0772,标准误 0.0203。这个动态总体与 did 官方文档的 -0.0772(标准误 0.0203)一致。
两个总体效应回答的问题不同,数值不能互相替代。写论文时说明用的是哪一种。事件研究图来自 dynamic 的逐期结果,e = -1 是基准,没有标准误。
set.seed(20261106); simple  <- aggte(gt, type = "simple",  bstrap = TRUE, biters = 999, clustervars = "countyreal")
set.seed(20261106); dynamic <- aggte(gt, type = "dynamic", bstrap = TRUE, biters = 999, clustervars = "countyreal")
ggdid(dynamic)   # 事件研究图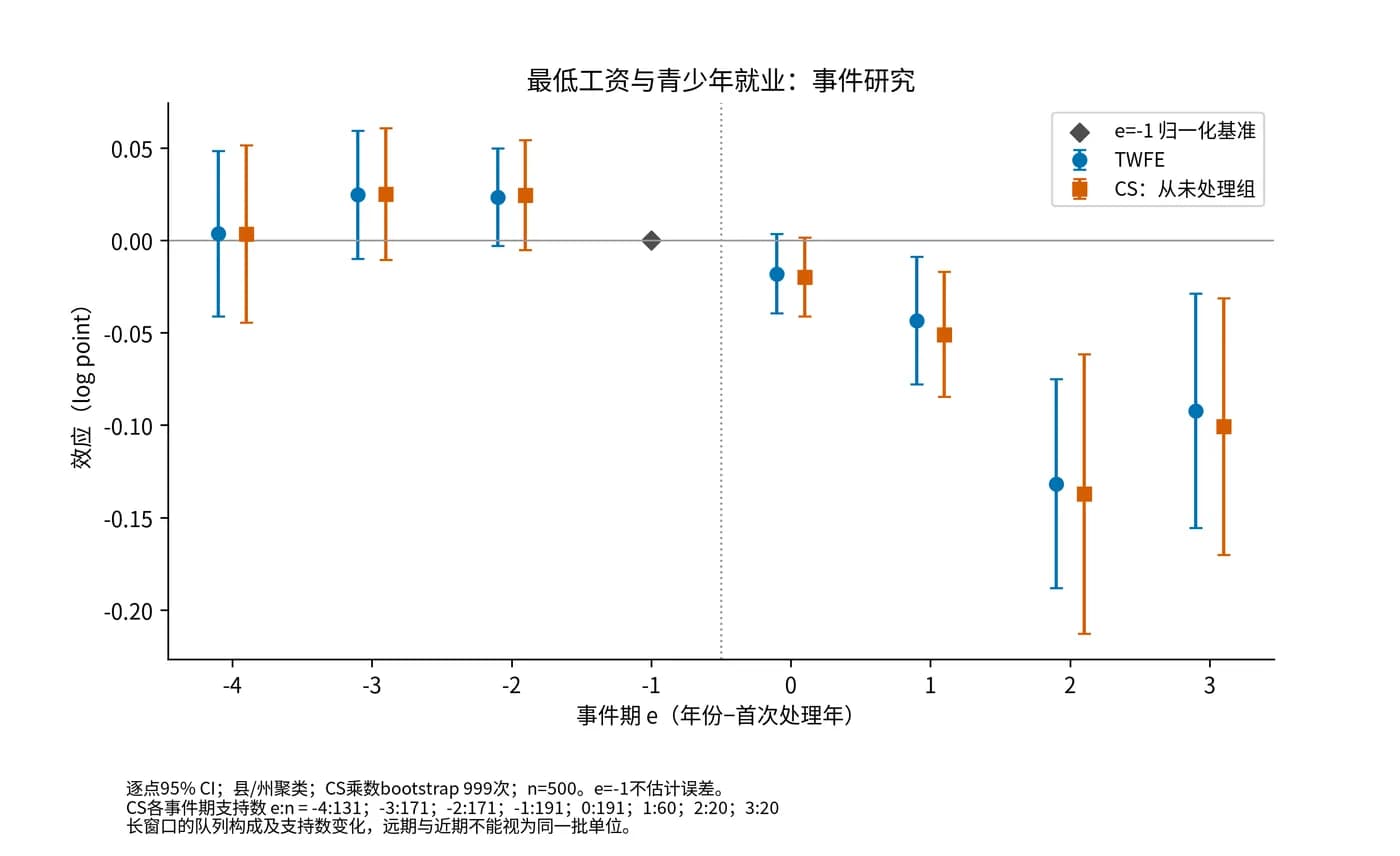
第 6 步
为什么做这一步平行趋势是指没有政策时,处理组和对照组的结果变化趋势相同。它不能被直接检验,只能看处理前的事件研究系数是否接近 0。
mpdta 的处理前系数是 e = -4:0.0033,e = -3:0.0250,e = -2:0.0245,标准误 0.015 到 0.024。三个系数的联合检验 p = 0.168,TWFE 事件研究的同一检验 p = 0.181,都没有拒绝。
Castle 要区分近端和远端。e = -6 到 -2 的系数在 -0.008 到 0.058 之间,标准误 0.05 到 0.07。e = -9 到 -7 的系数是 -0.404、-0.124、-0.233,但这三期分别只有 1、3、7 个州有观测,近端各期有 20 到 21 个州。包含全部处理前系数的联合检验 p 值小于 0.001,只检验 e = -4 到 -2 时 p = 0.186。远端系数的样本太少,不能和近端系数同等看待。
处理前系数接近 0 不能证明平行趋势成立,检验的功效也有限。第 8 步用 HonestDiD 回答另一个问题:结论能承受多大的违背。
gt$Wpval        # att_gt 的处理前联合检验
ggdid(dynamic)  # 处理前系数应接近 0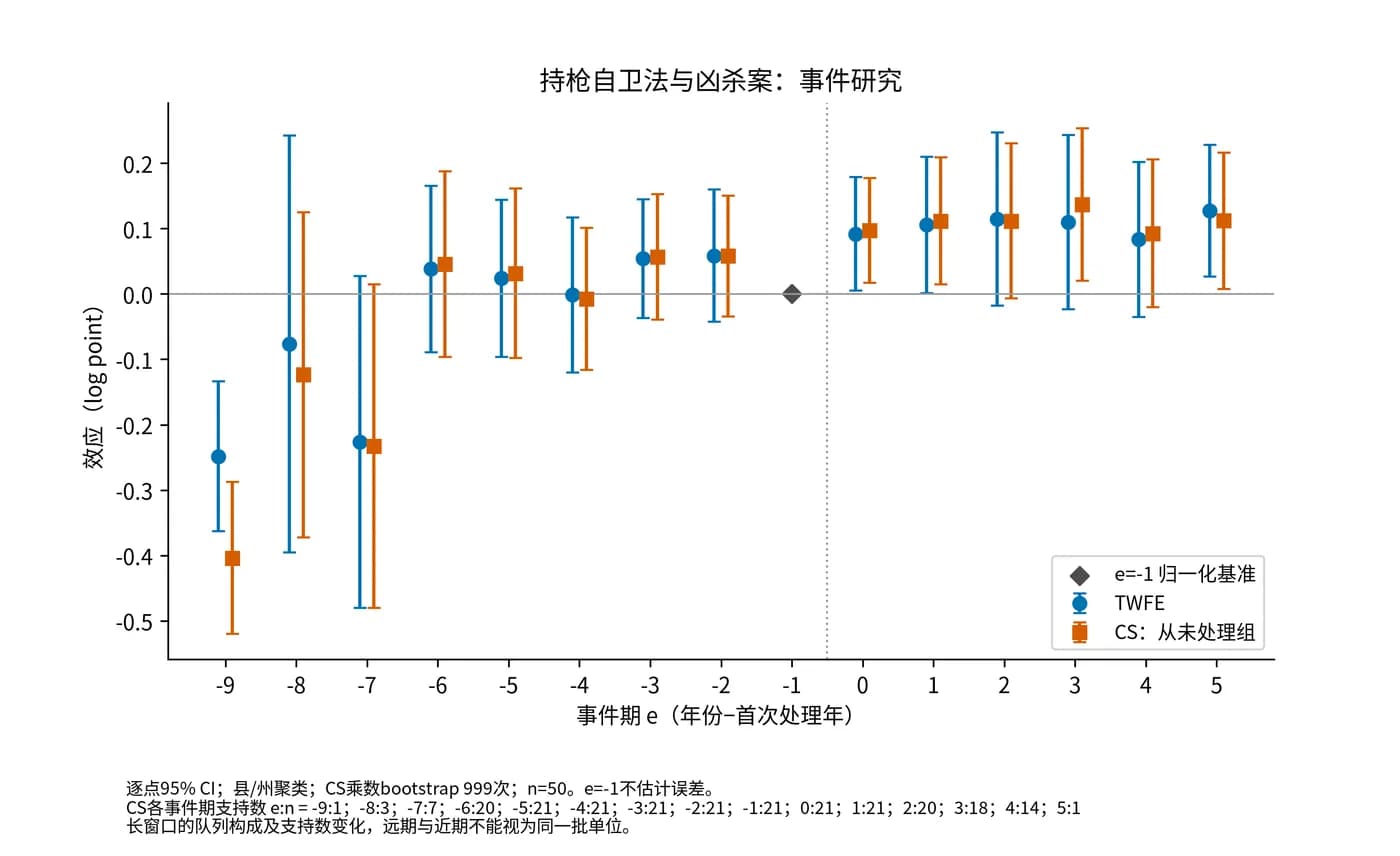
第 7 步
为什么做这一步结论不应依赖某一种估计量。Sun–Abraham 和 Borusyak–Jaravel–Spiess(BJS)插补估计是两种常用的替代,用同一份数据各估计一次。
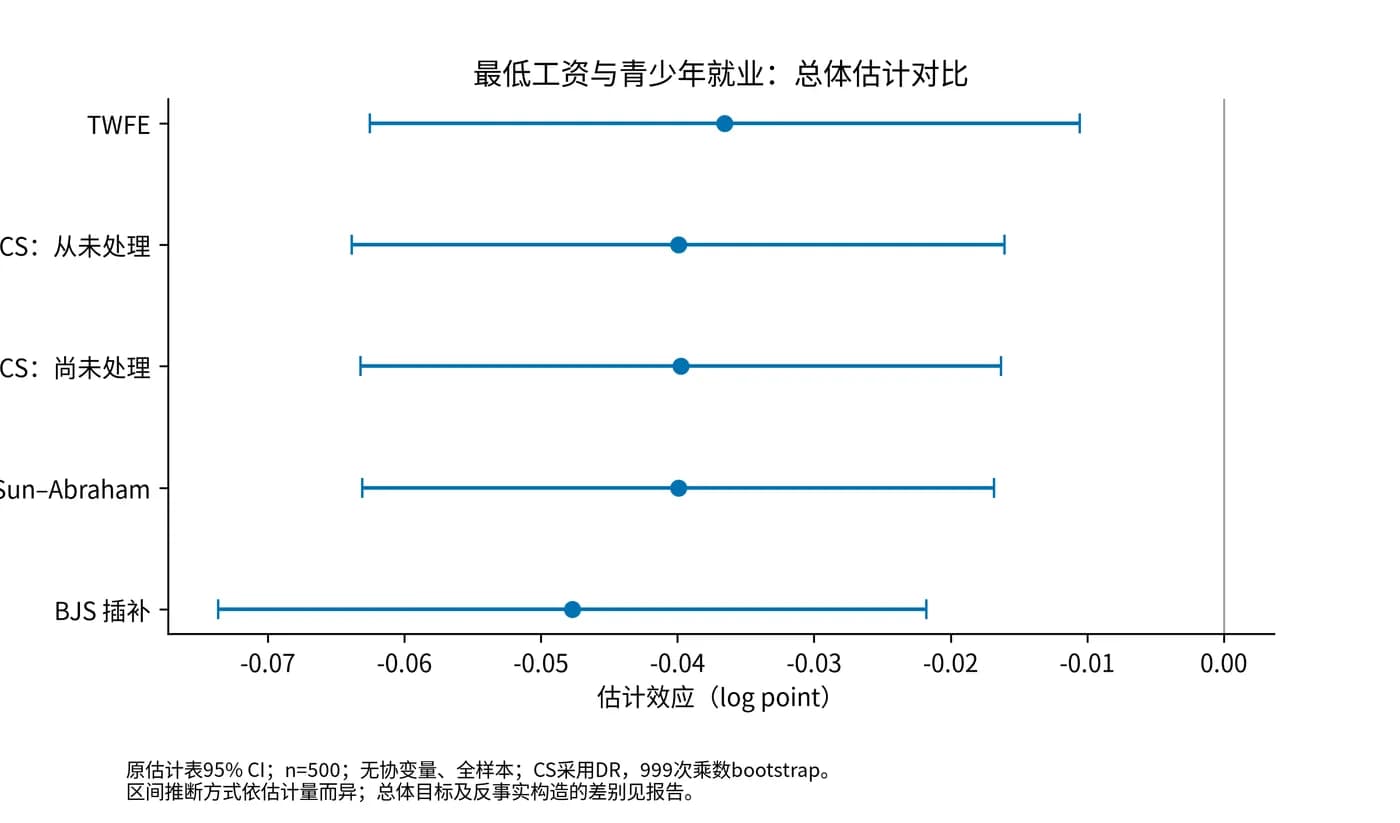
Sun–Abraham 用 fixest 的 sunab 实现,对照组同样是从未处理的个体,所以点估计与 Callaway–Sant'Anna 相同,标准误略有差别。BJS 用所有未处理的观测拟合反事实,再与处理后的观测比较,用 didimputation 包实现。
最低工资数据里,除 BJS 的 -0.0477 外,其余估计量都在 -0.0365 到 -0.0400 之间。持枪自卫法数据里,TWFE 是 0.0818,Callaway–Sant'Anna 和 Sun–Abraham 是 0.1104,BJS 是 0.0798。各估计量的差异都小于标准误(mpdta 约 0.012,Castle 约 0.04 到 0.06),用这样大的样本无法区分它们。
d$g_sa <- ifelse(d$first.treat == 0, 9999, d$first.treat)
sa  <- feols(lemp ~ sunab(g_sa, year, ref.p = -1) | countyreal + year, d, cluster = ~countyreal)
aggregate(sa, agg = "ATT")
bjs <- did_imputation(d, yname = "lemp", gname = "first.treat", tname = "year",
idname = "countyreal", first_stage = ~ 0 | countyreal + year, cluster_var = "countyreal")| 估计量 | mpdta 估计值(标准误) | Castle 估计值(标准误) |
|---|---|---|
| TWFE | -0.0365 (0.0133) | 0.0818 (0.0589) |
| Callaway–Sant'Anna,从未处理组 | -0.0400 (0.0122) | 0.1104 (0.0420) |
| Callaway–Sant'Anna,尚未处理组 | -0.0398 (0.0120) | 0.1094 (0.0389) |
| Sun–Abraham | -0.0400 (0.0118) | 0.1104 (0.0413) |
| BJS 插补 | -0.0477 (0.0132) | 0.0798 (0.0609) |
第 8 步
为什么做这一步HonestDiD 回答平行趋势在处理后可能被违背多少,结论还成不成立;置换检验在没有渐近理论支持时,用随机重排处理时点得到一个参照分布。
HonestDiD 的相对大小约束写作 Mbar:处理后趋势的偏离不超过处理前最大偏离的 Mbar 倍。Mbar = 0 就是通常的置信区间。以 mpdta 的事件研究为输入,处理当期效应(e = 0)在 Mbar = 0 时的区间是 [-0.0429, 0.0031],已经包含 0。处理后各期效应的加权平均在 Mbar = 0 时是 [-0.0629, -0.0172],Mbar = 0.25 时是 [-0.0723, -0.0068],仍不含 0;Mbar = 0.5 时是 [-0.0860, 0.0073],包含 0。
这说明“处理后平均效应为负”的结论,能承受处理后趋势偏离不超过处理前最大偏离 0.25 倍的违背,到 0.5 倍时不能。Castle 的等权动态平均也是类似的情形:Mbar = 0 时区间是 [0.040, 0.180],Mbar = 0.25 时是 [-0.036, 0.256]。
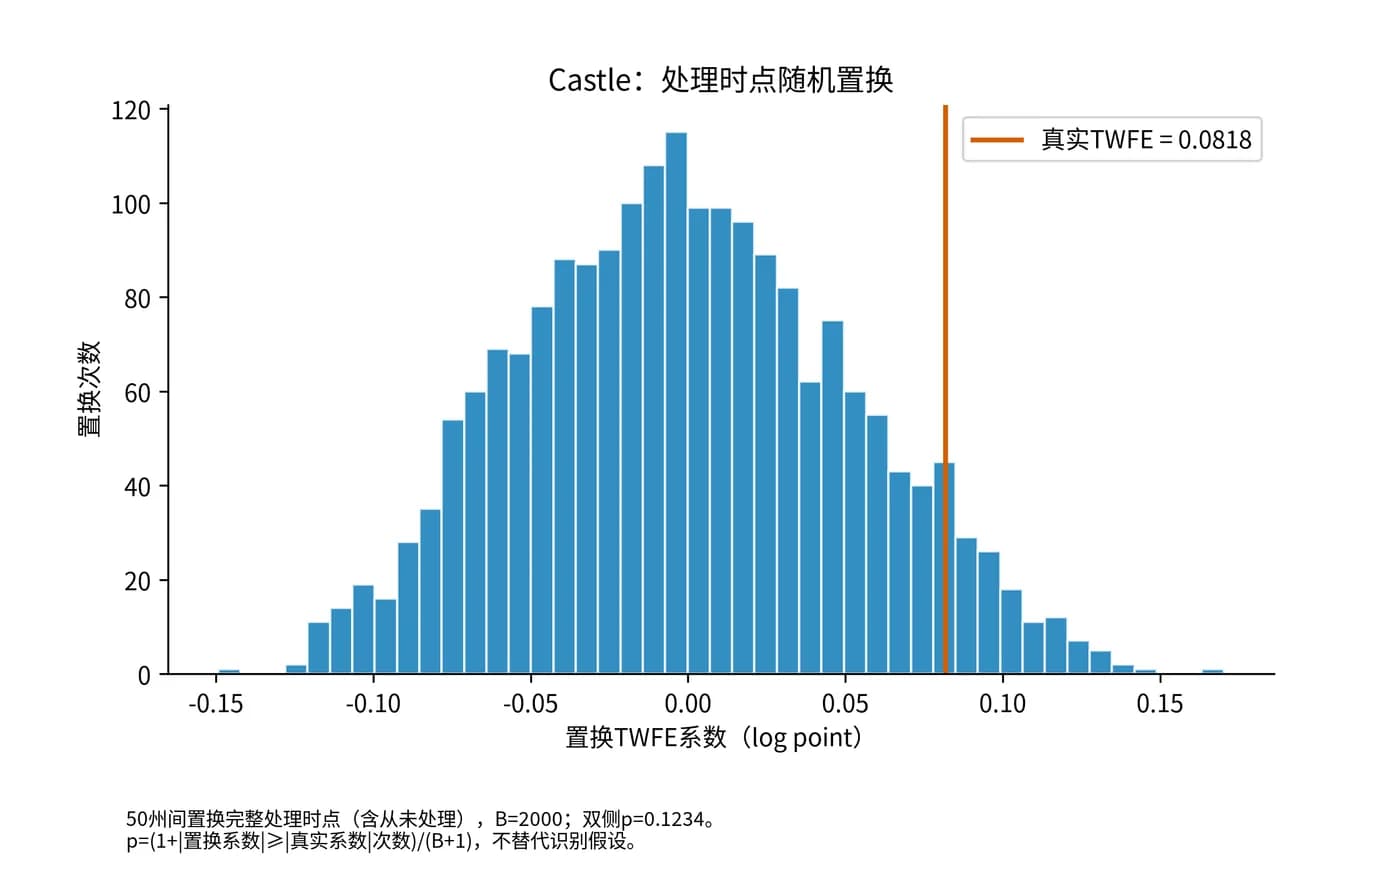
置换检验用 Castle 数据。把 50 个州的处理年份在州之间随机重排 2000 次,每次重算 TWFE 系数。真实系数 0.0818 在置换分布里,有 246 次置换的系数绝对值不小于它,p = (1 + 246) / 2001 = 0.123。这与 TWFE 的 t 检验(p = 0.171)一致:用 TWFE 看,这份数据不能拒绝零效应。国内文献里的“安慰剂检验”常指这种随机分配处理再重复估计的做法。
IF <- dynamic$inf.function$dynamic.inf.func.e
V  <- crossprod(IF) / nrow(IF)^2
keep <- dynamic$egt != -1
res <- createSensitivityResults_relativeMagnitudes(
  betahat = dynamic$att.egt[keep], sigma = V[keep, keep],
  numPrePeriods = 3, numPostPeriods = 4,
Mbarvec = c(0, 0.25, 0.5, 1, 2), l_vec = c(191, 60, 20, 20) / 291, alpha = 0.05)gp <- sample(g0) # g0 是各州的处理年份
Dm <- outer(gp, yrs, function(g, t) as.numeric(g > 0 & t >= g))
Dm <- Dm - rowMeans(Dm); Dm <- sweep(Dm, 2, colMeans(Dm), "-")
sum(Dm * Y) / sum(Dm^2) # 去掉两个固定效应后的 TWFE 系数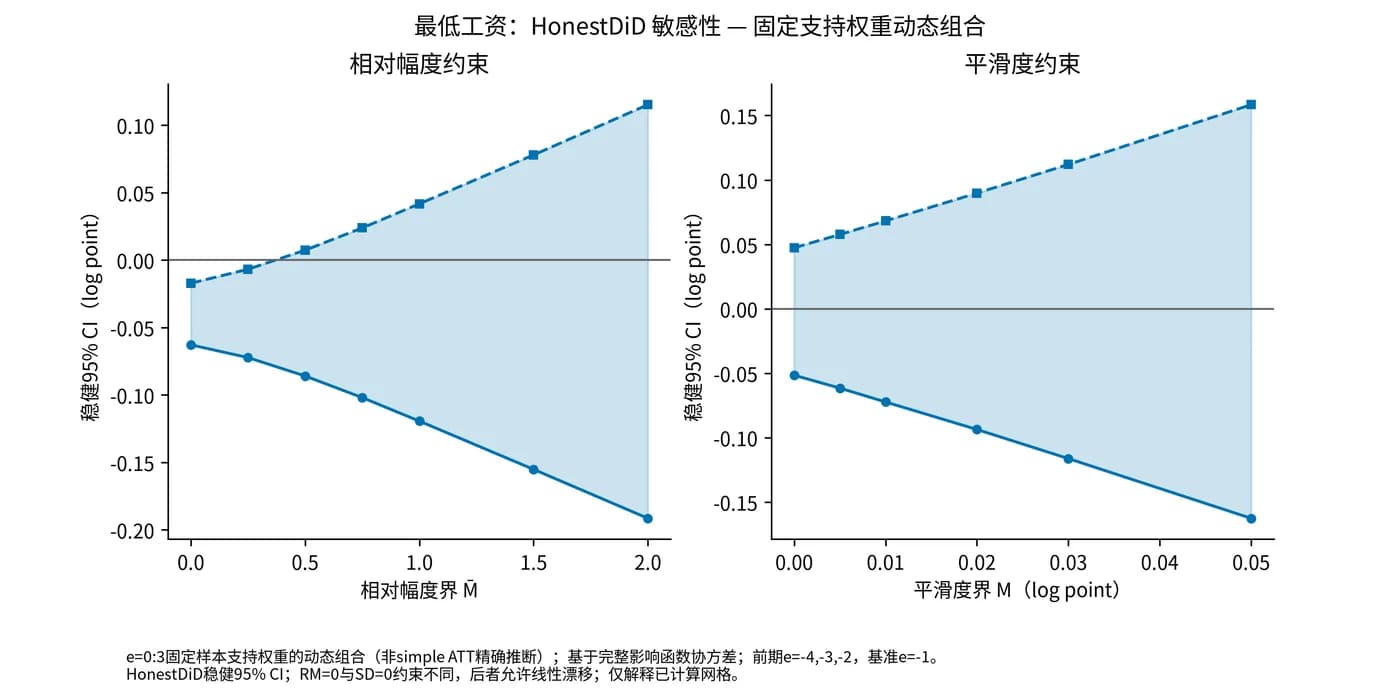
按你的情况选择
为什么做这一步Callaway–Sant'Anna 可以用两种对照组。选择取决于样本里从未处理的个体够不够多,以及能不能接受处理前没有预期效应的假定。
从未处理的个体够多、和处理组差异不大时,用从未处理组(nevertreated)。mpdta 有 309 个从未处理的县,Castle 有 29 个州。尚未处理组(notyettreated)把还没有被处理的个体也当对照,样本更大,但要假定处理前没有预期效应。
两种选择在本页数据上差别很小:mpdta 的 simple 总体效应分别是 -0.0400 和 -0.0398,Castle 分别是 0.1104 和 0.1094。从未处理的个体很少,或者和处理组差异很大时,才需要认真比较。
为什么做这一步协变量把平行趋势放宽成“条件平行趋势”:只要求特征相同的个体趋势相同。TWFE 和 Callaway–Sant'Anna 对协变量的处理方式不同。
不随时间变化的协变量会被个体固定效应吸收。mpdta 加入基期的 lpop 后,TWFE 系数仍是 -0.0365;Callaway–Sant'Anna(doubly robust,从未处理组)的总体效应从 -0.0400 变为 -0.0418,标准误从 0.0122 降到 0.0113。
加协变量需要处理组和对照组在协变量上有重叠。Castle 加入基期收入、失业率和贫困率后,2009 年批次只有 1 个州,估计时出现 overlap condition violated。遇到这种情况不要删掉失败的批次,应如实报告,并改用不依赖倾向得分的回归调整作补充。
为什么做这一步这些估计量在 Stata 里都有对应的命令。没有 Stata 许可证,或者想要可复现的脚本时,可以用 R。
同一估计量的 R 包和 Stata 命令用同一篇论文的方法,原则上点估计一致;bootstrap 的标准误和默认的基准期可能不同,did 包默认的基准期是处理前一期随时点变化(varying),本页用 universal,对比时先把设定对齐。
| 方法 | R 包和函数 | Stata 命令 |
|---|---|---|
| Callaway–Sant'Anna | did::att_gt, aggte | csdid |
| Goodman-Bacon 分解 | bacondecomp::bacon | bacondecomp |
| Sun–Abraham | fixest::sunab | eventstudyinteract |
| BJS 插补 | didimputation::did_imputation | did_imputation |
| HonestDiD | HonestDiD | honestdid |
| TWFE | fixest::feols | reghdfe |
为什么做这一步本页的数字来自 Scientify 的 Agent 按一份任务书独立完成的一次运行。你可以用同样的任务书做自己的课题。
任务书写明研究问题、数据、软件、检验要求、需要核对的文献和交付物。Agent 在云电脑上装包,跑估计,核对文献数值,生成 15 页中文报告、结果工作簿和可复现脚本,用时 33 分钟,没有租用外部算力。
Agent 在运行中自己发现并写进报告的限制有三条。一是最低工资的结果受最早处理的批次影响:去掉 2004 年批次的 20 个县后,Callaway–Sant'Anna 的总体效应从 -0.0400 变为 -0.0249。二是 Castle 的协变量模型在 2009 年批次重叠不足。三是 Cheng–Hoekstra 原文的付费页面打不开,它只引用了摘要里的约 8%,并标注没有核实原表系数。
原理与判断
为什么做这一步只有两期两组时,TWFE 就是普通 DID。处理时点交错后,它变成多个 2×2 比较的加权平均,权重取决于各批次的大小和处理时点。
处理效应在各批次、各时点相同时,这个加权平均仍然是正确的。处理效应随处理后时间变化,或者各批次不同,已经被处理的组做对照的比较就会把对照组自己的效应带进估计,结果可能偏离真实平均效应,甚至符号相反(Goodman-Bacon,2021)。
偏误有多大取决于这类比较的权重和效应的变化幅度。本页两份数据里这类比较的权重只有 5.4% 和 3.2%,TWFE 和新估计量的差别在标准误以内。权重小的数据集不会都这样,要用自己的数据跑一遍分解。
为什么做这一步不能。Bacon 权重只描述 2×2 比较在 TWFE 里的占比,它不能解释 TWFE 与新估计量的全部差异。
Castle 数据里,TWFE 是 0.0818,Callaway–Sant'Anna 是 0.1104,差 0.0286。已经被处理的组做对照的比较对 TWFE 的贡献只有 0.0022。处理组对从未处理组的比较平均是 0.0880,仍低于 0.1104。差异的另一部分来自 TWFE 和 Callaway–Sant'Anna 对批次与时点的加权方式不同。
所以应当同时报告 TWFE 和至少一个稳健估计量,写清它们的聚合对象和权重。两者接近时,说明结论对估计量不敏感;两者有差别时,先看分解和权重,再看效应是否随时间变化。
参考与附录
为什么做这一步下表列出本页能核实的对照项。没有核实的数值不写进表里。
did 包的 mpdta 是论文数据的子集,与论文表 3 的样本不同,数值不能逐项相等。TWFE 的 -0.0365 与论文的 -0.037 接近,simple 和 event study 的总体效应比论文小。动态总体和 ATT(g,t) 与 did 官方文档一致,说明在同一数据上本页的流程与官方一致。
Cheng 和 Hoekstra(2013)摘要称持枪自卫法使凶杀案净增加 8%,并且显著。本页 TWFE 的 0.0818 与它的量级接近,但本页没有使用原文的人口权重和控制变量,标准误 0.0589,不显著,也没有复现原文的显著性。
| 来源 | 量 | 文献值(标准误) | 本页(标准误) |
|---|---|---|---|
| CS 2021 论文表 3(a) | TWFE | -0.037 (0.006) | -0.0365 (0.0133) |
| CS 2021 论文表 3(a) | Simple weighted average | -0.052 (0.006) | -0.0400 (0.0122) |
| CS 2021 论文表 3(a) | Event study | -0.090 (0.013) | -0.0772 (0.0203) |
| did 官方文档 | 动态总体 ATT | -0.0772 (0.0203) | -0.0772 (0.0203) |
| did 官方文档 | ATT(2004, 2004 到 2007) | -0.0105、-0.0704、-0.1373、-0.1008 | -0.0105、-0.0704、-0.1373、-0.1008 |
| Cheng–Hoekstra 2013 摘要 | 凶杀案净增加 | 约 8%,显著 | 0.0818(0.0589) |
为什么做这一步说明运行环境、用时和复核方式。
2026-11-06,Scientify 的 Agent 在标准档云电脑(2 核 CPU)上按任务书完成全部分析,用时 33 分钟。R 为 4.4.3,did 2.5.1,fixest 0.14.2,bacondecomp 0.1.1,didimputation 0.5.1,HonestDiD 0.2.8。随机种子为 20261106,乘数 bootstrap 999 次。
2026-11-09,在另一台云电脑上清空中间结果后重跑:Agent 的完整脚本得到的 TWFE、Callaway–Sant'Anna、Bacon 权重、HonestDiD 区间和置换 p 值与原结果一致。本页下载的精简脚本在同一台云电脑上运行,两个估计脚本各用几秒,HonestDiD 脚本约 1 分钟。唯一的差别是 Castle 的 Callaway–Sant'Anna 标准误,它依赖 bootstrap 随机数(0.0420 和 0.0397)。
按报错或现象排错
下面的报错都在本页的运行中出现过。
overlap condition violated for group 2009
原因:加入协变量后,某个批次的个体太少,倾向得分估计不出来。本页的 2009 年批次只有 1 个州。
怎么解决:保留失败的批次和 NA,不要删掉它来让程序通过。同时报告不加协变量的结果,再用同一协变量的回归调整(est_method = "reg")作补充。
Missing values found in att_gt() estimates
原因:上一条的后续:失败批次的 ATT(g,t) 是 NA,aggte 汇总时遇到缺失值。
怎么解决:汇总结果只包含能识别的批次,要在报告里写明哪些批次缺失。
Not returning pre-test Wald statistic due to singular covariance matrix
原因:处理前检验用的协方差矩阵是奇异的,多见于处理前系数多、部分批次只有 1 个州的面板。Castle 数据运行 att_gt 时会出现。
怎么解决:不要把缺失的 Wald 统计量写成通过检验。改在事件期层面检验可识别的处理前系数,例如 e = -4 到 -2(本页 p = 0.186),并说明远端系数的样本很少。
Some groups in your dataset have very few observations, which may cause estimation problems
原因:有的处理批次只有 1 到 2 个个体。Castle 的 2005、2007、2008、2009 批次触发了这条警告。
怎么解决:这是警告,不影响运行。小批次的 ATT(g,t) 很不精确,解读单个批次的结果时要看置信区间,汇总结果对这些批次的依赖也要在局限里写明。
安装 HonestDiD 失败,提示 The 'rustc' compiler was not found on the PATH
原因:HonestDiD 依赖 CVXR,CVXR 依赖 clarabel,clarabel 要从源码编译,需要 Rust(rustc 1.70 或更高)。云电脑镜像没有 Rust 工具链,首轮安装用了 649 秒才报出这个错。
怎么解决:先安装 Rust,再安装 clarabel 和 HonestDiD。Agent 把 rustup(minimal 配置)装在工作区里,并设 MAKEFLAGS=-j1、CARGO_BUILD_JOBS=1 降低内存占用,补装用了约 147 秒。
export MAKEFLAGS=-j1 CARGO_BUILD_JOBS=1
Rscript -e 'install.packages("HonestDiD")'
The estimation was done without fixed-effects (FE). The FE coefficients cannot be retrieved.
原因:用 did_imputation 时在第一阶段加入了不随时间变化的协变量(mpdta 的基期 lpop),它与个体固定效应共线。
怎么解决:第一阶段只写 ~ 0 | 个体 + 年份。时间不变的协变量已经被个体固定效应吸收,不需要再放进去。
Error: all(complete.cases(d)) is not TRUE
原因:在检查数据完整性时,把为从未处理个体生成的事件期变量(NA)也当成了缺失。
怎么解决:只对原始数据列做完整性检查(例如 complete.cases(mpdta)),不要对生成的列检查。
资料来源
- Callaway, B., Sant'Anna, P. H. C. (2021). Difference-in-Differences with multiple time periods. Journal of Econometrics. — Callaway–Sant'Anna 估计量;表 3 取自 arXiv 1803.09015
- Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics. — Bacon 分解
- Sun, L., Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. Journal of Econometrics. — Sun–Abraham 估计量
- Borusyak, K., Jaravel, X., Spiess, J. (2024). Revisiting Event-Study Designs: Robust and Efficient Estimation. Review of Economic Studies. — BJS 插补估计
- Rambachan, A., Roth, J. (2023). A More Credible Approach to Parallel Trends. Review of Economic Studies. — HonestDiD 的方法
- Baker, A. C., Larcker, D. F., Wang, C. C. Y. (2022). How much should we trust staggered difference-in-differences estimates? Journal of Financial Economics. — TWFE 在交错处理下的模拟证据
- Cheng, C., Hoekstra, M. (2013). Does Strengthening Self-Defense Law Deter Crime or Escalate Violence? Journal of Human Resources. — 持枪自卫法数据的原始研究,本页只引用摘要
- did package documentation: Getting started with the did package — 页面日期 2026-07-30,did 2.5.1;mpdta 的说明和 ATT(g,t) 参考值
- Cunningham, S. Causal Inference: The Mixtape, castle.dta — Castle 数据的下载来源