 Scientify
本页说明
教程- 这页解决什么
- 你想用 NHANES 写一篇关联研究,但不清楚文件在哪里下载、权重怎么选、死亡数据怎么链接、Cox 和 RCS 怎么做才算正确。
- 适合谁
- 做公共数据库挖掘的医学研究生和临床医生。需要会用 R,了解 Cox 回归的基本概念。
- 读完你会得到
- 读完会得到一套完整的 NHANES 死亡结局分析流程、每一步应该得到的结果,以及一份可对照的真实结果。
- 覆盖
- NHANES 官方文件的下载路径与变量查找
- NCHS 公共死亡链接文件的定宽格式解析与心血管死亡定义
- 空腹子样本权重的选择与多周期合并系数
- TyG 指数公式与单位换算
- survey 包加权 Cox 回归、RCS 曲线、加权 KM 曲线
- 亚组交互作用、比例风险检验和敏感性分析的做法与真实结果
- 不覆盖
- 饮食数据(24 小时膳食回顾)的两日权重
- 孟德尔随机化等因果推断方法
- 论文引言和讨论的写法
主线:一步步做完
第 1 步
为什么做这一步NHANES 每个周期的每个模块是一个单独的 XPT 文件,要先确定需要哪些文件。
NHANES 官网入口是 wwwn.cdc.gov/nchs/nhanes。数据按周期发布,1999 年起每两年一个周期,每个周期分人口学、膳食、体格检查、实验室和问卷五类模块,每个模块下是若干个 XPT 文件。在官网选周期、再选模块,就能看到文件列表和变量说明(Doc File)。
NHANES 由美国 CDC 下属的 NCHS 组织,1999 年起每两年一个周期,数据免费公开。每个周期的文件名用字母后缀区分:1999–2000 无后缀,2001–2002 为 _B,依次到 2017–2018 为 _J。所有文件通过受试者编号 SEQN 合并。
本例从十个周期共下载 100 个官方文件。CDC 已调整下载地址,旧路径 /Nchs/Nhanes/2017-2018/DEMO_J.XPT 会返回 404 网页,需要使用新路径。下载后检查文件开头,确认拿到的是 XPT 数据,不是 HTML 错误页。
https://wwwn.cdc.gov/Nchs/Data/Nhanes/Public/2017/DataFiles/DEMO_J.xpt
# 年份写周期的第一年,文件名带周期后缀library(haven)
demo <- read_xpt("DEMO_J.xpt")
glu <- read_xpt("GLU_J.xpt")
trig <- read_xpt("TRIGLY_J.xpt")
d <- Reduce(function(x, y) merge(x, y, by = "SEQN", all.x = TRUE), list(demo, glu, trig))| 周期 | 人口学 | 空腹血糖 | 甘油三酯 |
|---|---|---|---|
| 1999–2000 | DEMO | LAB10AM | LAB13AM |
| 2001–2002 | DEMO_B | L10AM_B | L13AM_B |
| 2003–2004 | DEMO_C | L10AM_C | L13AM_C |
| 2005–2006 | DEMO_D | GLU_D | TRIGLY_D |
| 2007–2018 | DEMO_E … DEMO_J | GLU_E … GLU_J | TRIGLY_E … TRIGLY_J |
第 2 步
为什么做这一步死亡结局来自 NCHS 把 NHANES 与国家死亡索引(NDI)链接后发布的公共文件。
本例使用 2019 年公共版链接死亡文件,每个周期一个 .dat 文件。文件是定宽格式,需要按 NCHS 官方提供的读取程序指定列位置,不能当作 CSV 读取。
心血管死亡定义为 UCOD_LEADING 等于 001(心脏病)或 005(脑血管病)。随访时间用 PERMTH_EXM(从体检到死亡或随访截止的月数)。读完后检查死因代码频数和随访时间范围。
https://ftp.cdc.gov/pub/Health_Statistics/NCHS/datalinkage/linked_mortality/NHANES_2017_2018_MORT_2019_PUBLIC.dat| 变量 | 列位置 | 含义 |
|---|---|---|
| SEQN | 1–6 | 受试者编号 |
| ELIGSTAT | 15 | 是否符合链接资格,1 为符合 |
| MORTSTAT | 16 | 死亡状态,1 为死亡 |
| UCOD_LEADING | 17–19 | 主要死因分类 |
| PERMTH_INT | 43–45 | 从访谈起的随访月数 |
| PERMTH_EXM | 46–48 | 从体检起的随访月数 |
第 3 步
为什么做这一步NHANES 是复杂抽样调查,不加权得到的是样本结果,不能代表美国人群。
选权重的规则是:分析用到的变量中,来自最小子样本的那个决定权重。空腹血糖和甘油三酯只在上午空腹子样本中测量,因此 TyG 研究要用空腹子样本权重(WTSAF2YR,1999–2002 为 WTSAF4YR),不能用体检权重 WTMEC2YR。
多周期合并时,每个周期的权重乘以“该周期年数 / 总年数”。本例合并 20 年:1999–2002 的四年权重乘以 4/20,2003 年起每个两年权重乘以 2/20。设计变量为 SDMVPSU(PSU)和 SDMVSTRA(层),二者在 DEMO 文件中。
library(survey)
d$wt20 <- ifelse(d$cycle %in% c("1999-2000", "2001-2002"),
                 d$WTSAF4YR * 4 / 20,
                 d$WTSAF2YR * 2 / 20)
options(survey.lonely.psu = "adjust")
des <- svydesign(ids = ~SDMVPSU, strata = ~SDMVSTRA,
                 weights = ~wt20, nest = TRUE, data = d)
# 先建全样本设计,再用 subset() 取分析人群,不要先删行再建设计
des_a <- subset(des, analysis_flag == 1)第 4 步
为什么做这一步确定暴露变量的计算方法和最终分析人群。
NHANES 的 LBXTR 和 LBXGLU 已经是 mg/dL,直接代入,不要再换算一次。纳入标准为年龄 ≥20 岁、未妊娠、空腹血糖和甘油三酯均为正值、空腹权重大于 0、符合死亡链接资格且体检后随访时间大于 0。
TyG = ln[ TG (mg/dL) × FPG (mg/dL) / 2 ]

# 单位为 mmol/L 时先换算:TG × 88.57,葡萄糖 × 18.018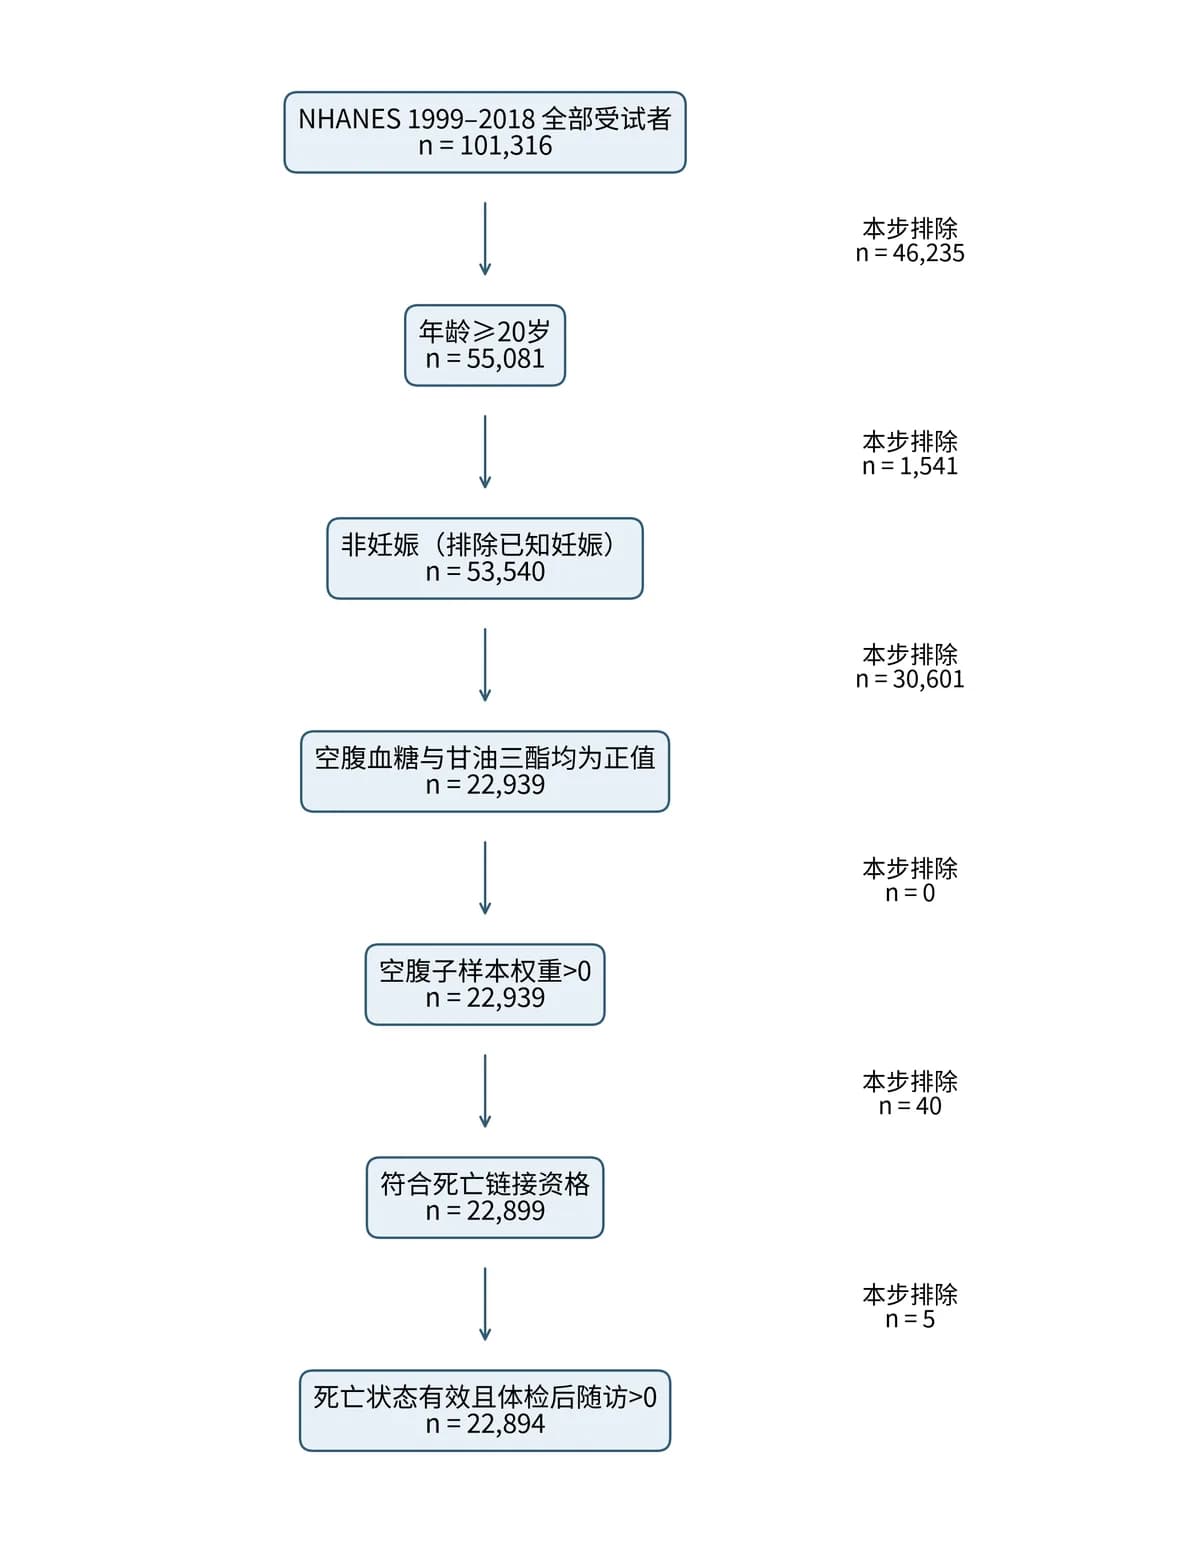
第 5 步
为什么做这一步估计 TyG 每升高 1 个单位,死亡风险变化多少。
完全调整后,TyG 的线性 HR 置信区间跨过 1。线性项不显著不等于没有关联,下一步用 RCS 检查是否存在非线性关系。95% 置信区间跨过 1 时,不应宣称存在统计学关联。
fit <- svycoxph(Surv(PERMTH_EXM, MORTSTAT) ~ tyg + age + sex + race +
                  edu + pir + smoke + bmi + diabetes + hypertension +
                  cvd + cancer, design = des_a)
summary(fit)| 结局 | 模型 3:每 1 单位 TyG 的 HR (95% CI) |
|---|---|
| 全因死亡 | 1.03 (0.95–1.12) |
| 心血管死亡 | 1.10 (0.93–1.29) |
第 6 步
为什么做这一步RCS 不预先假设线性关系,用来检验暴露与结局之间是否有曲线关系。
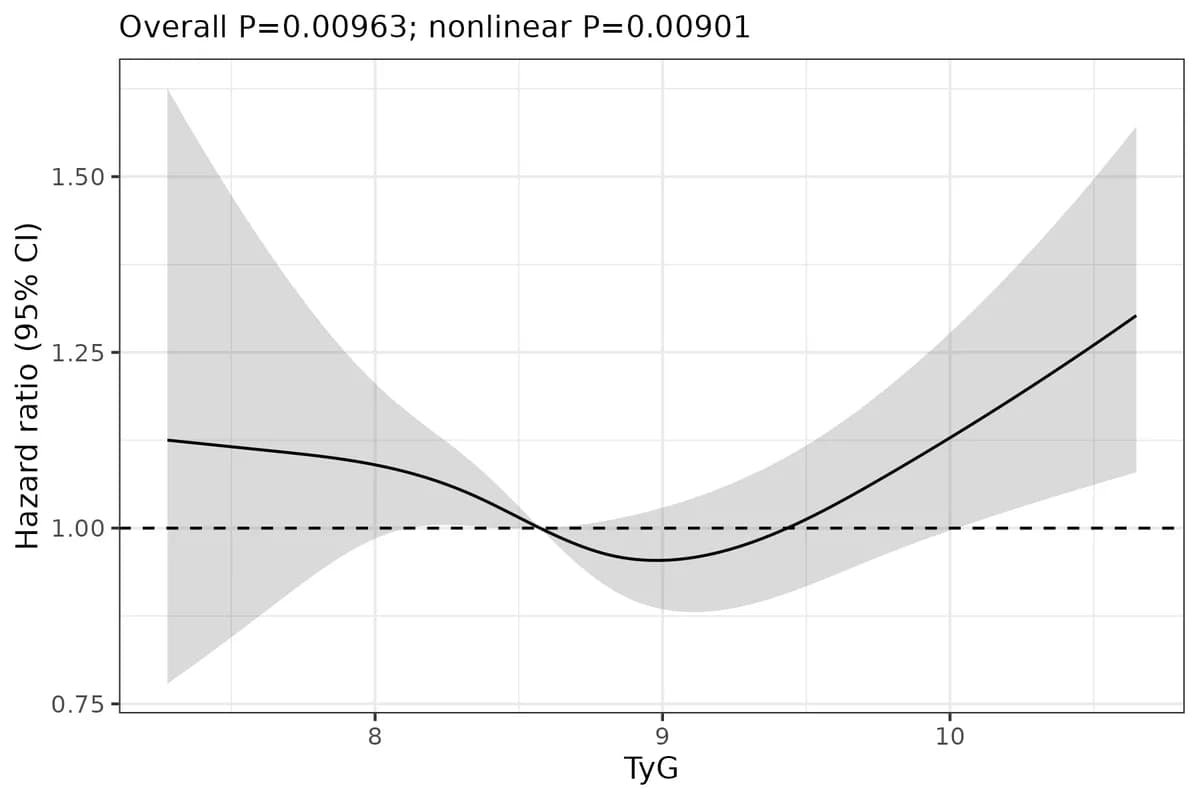
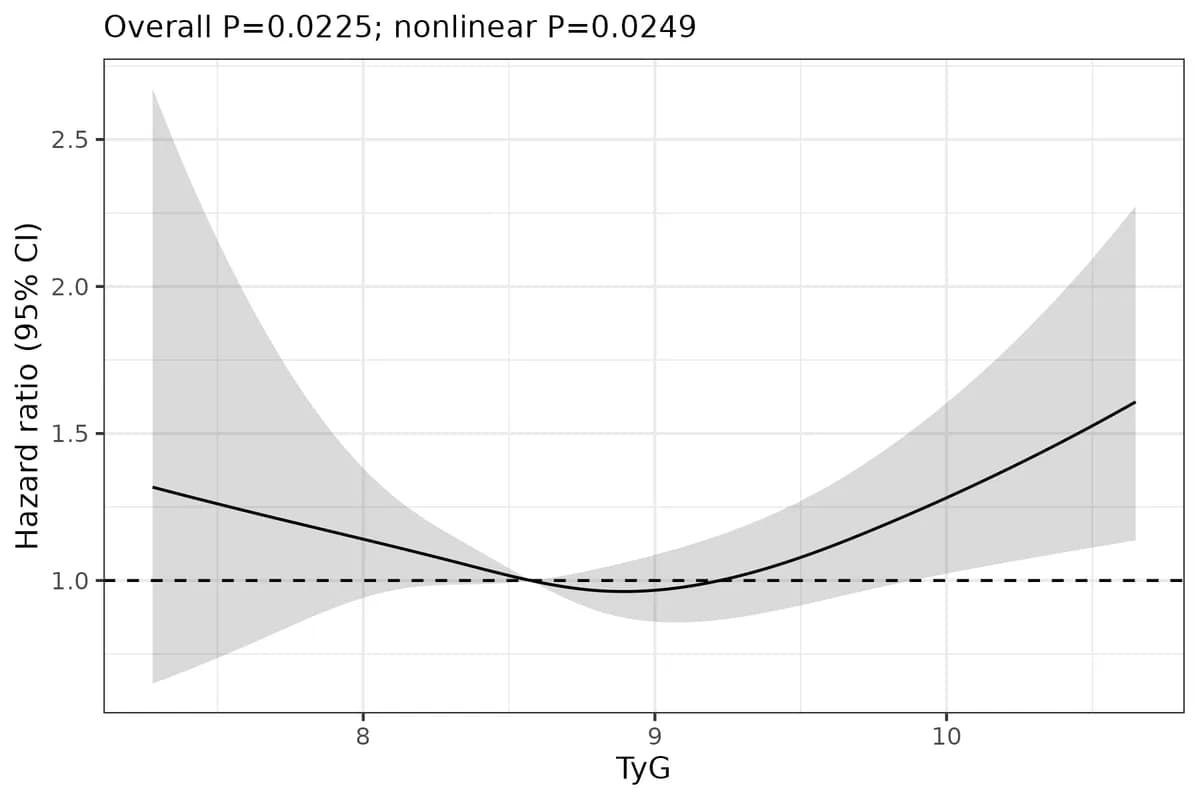
本例在加权 Cox 模型中使用 4 个结点,取加权 TyG 分布的第 5、35、65、95 百分位(7.63、8.33、8.82、9.76),参考值为加权中位数 8.57。RCS 输出两个 P 值:总体 P 检验 TyG 与死亡是否有关联,非线性 P 检验曲线是否偏离直线。
全因死亡的总体 P = 0.0096,非线性 P = 0.0090,曲线呈 U 形,最低点约在 TyG 9.0。心血管死亡的非线性 P = 0.025。
第 7 步
为什么做这一步Cox 模型假设 HR 不随时间变化,需要检验。KM 曲线展示各组生存情况。
直接对 svycoxph 的结果调用 cox.zph 会得到接近 1 的 P 值,这是权重尺度造成的假象,不能用。本例把随访时间切成 0–60、60–120、>120 个月三段,在加权模型中加入 TyG × 时段交互项,用设计校正的 Wald 检验:全因死亡 P = 0.034,提示违反比例风险假设,因此同时报告分时段 HR;心血管死亡 P = 0.49。
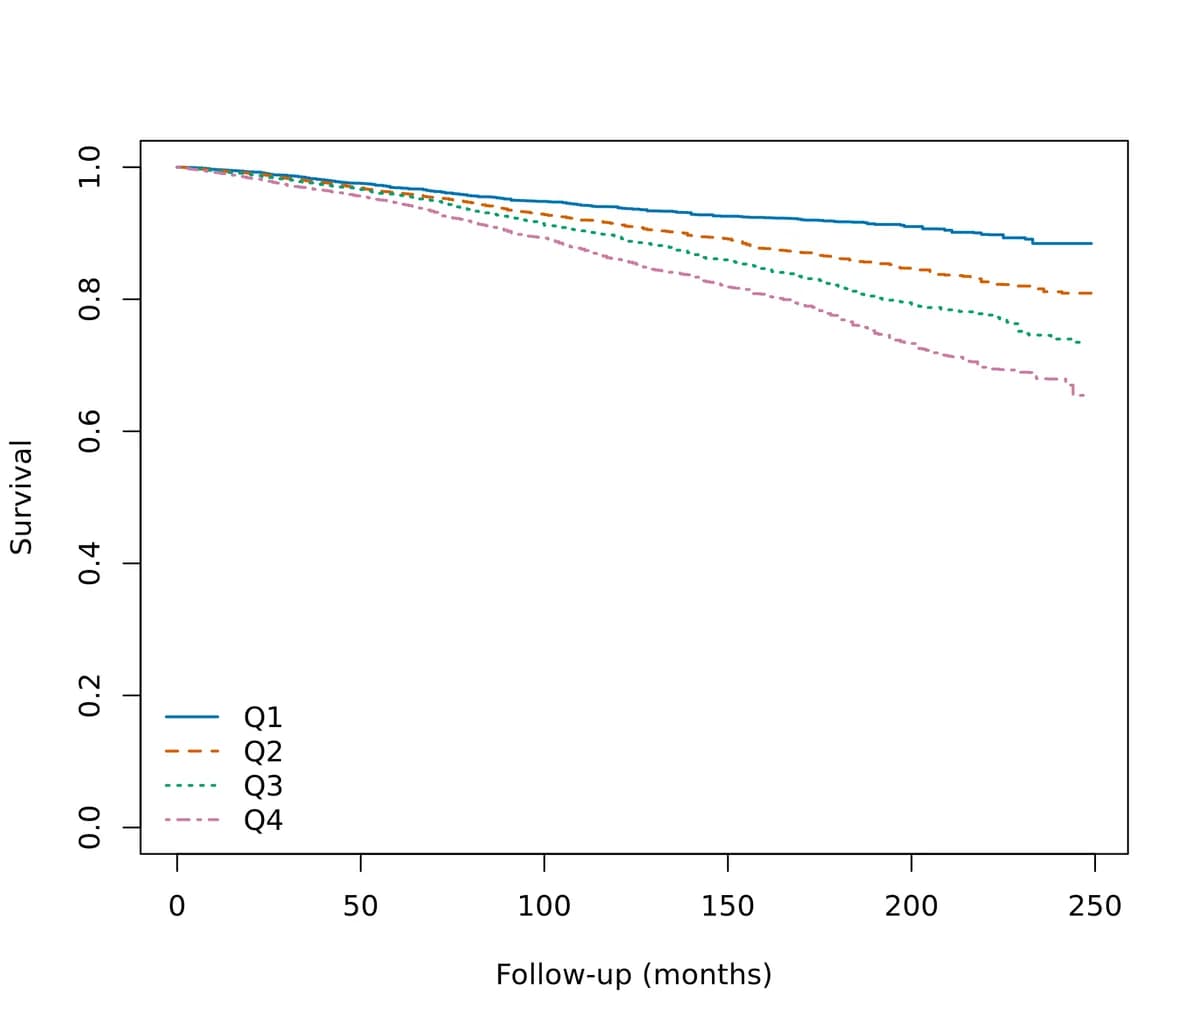
加权 KM 曲线用 survey::svykm 按 TyG 四分位数绘制,组间比较用 survey::svylogrank。图中曲线必须是加权结果,未加权曲线不能标成加权。
第 8 步
为什么做这一步检验 TyG 与死亡的关联在不同人群中是否不同。
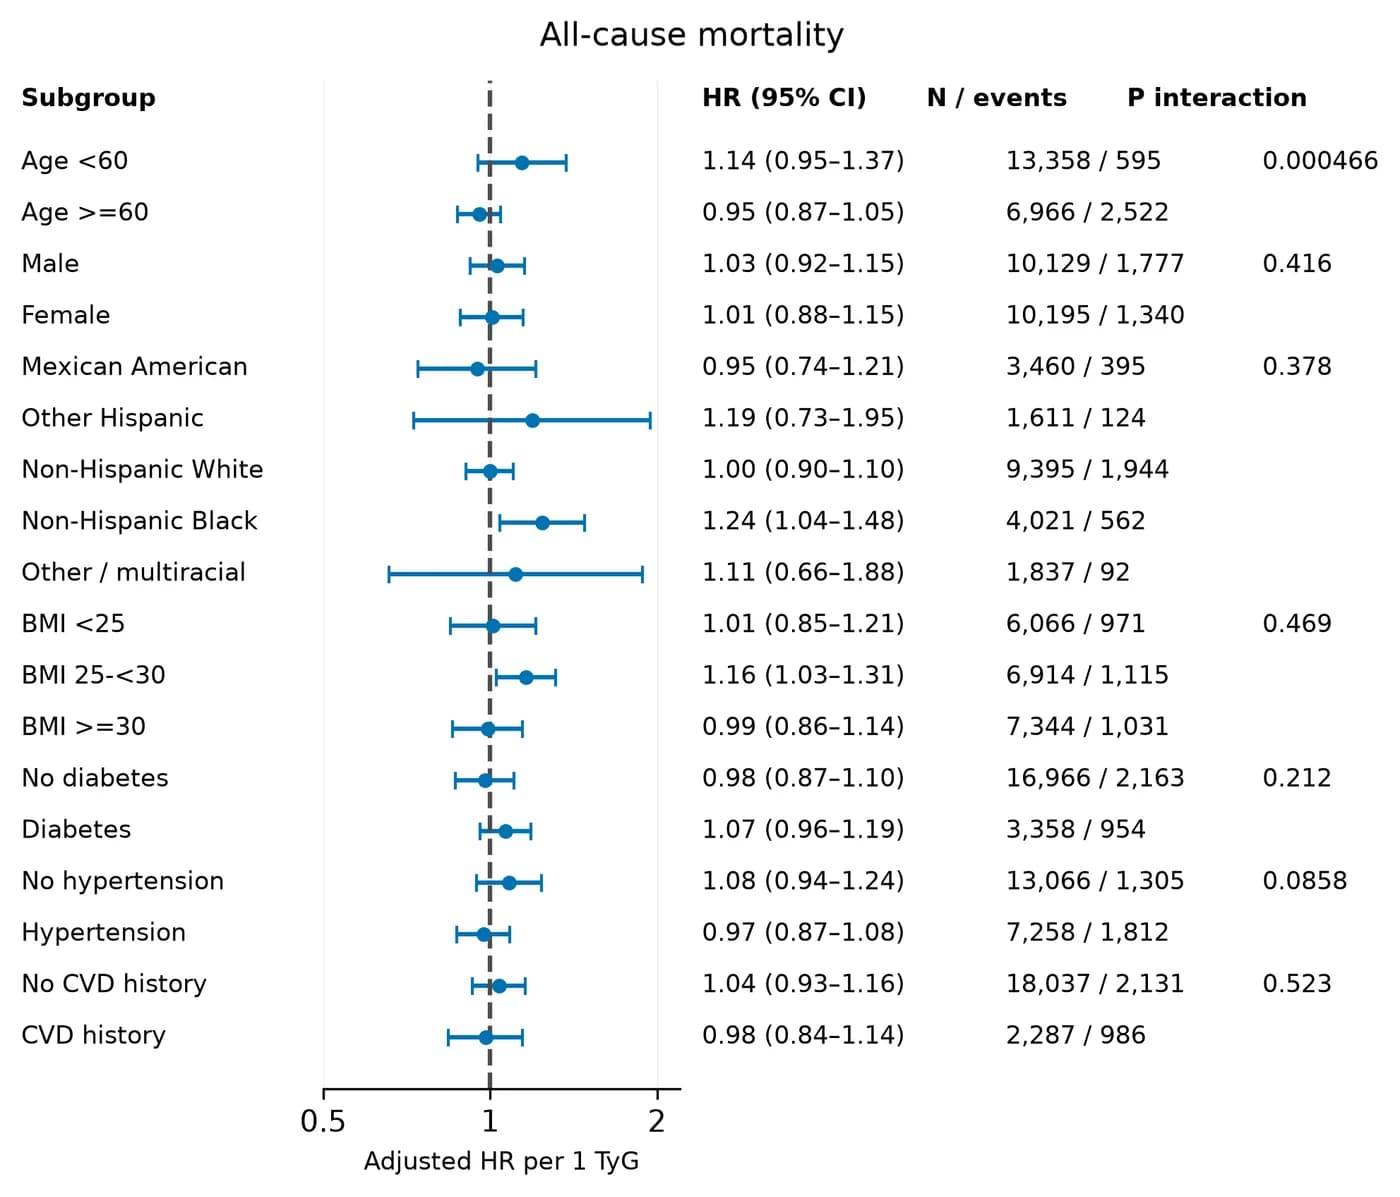
本例预设 7 类亚组:年龄(<60 / ≥60)、性别、种族、BMI、糖尿病、高血压、心血管病史。每层报告 HR、95% CI、人数和事件数,并给出交互作用 P 值。只有年龄的交互作用显著(P < 0.001):<60 岁 HR 1.14(0.95–1.37),≥60 岁 HR 0.95(0.87–1.05)。
判断亚组差异要看交互作用 P 值,不能用“一个亚组显著、另一个不显著”代替。本例非西班牙裔黑人亚组 HR 1.24(1.04–1.48)单独显著,但种族交互作用 P = 0.378,不能说 TyG 只在该人群中有关联。亚组检验未做多重比较校正,按探索性结果解释。
第 9 步
为什么做这一步换一种合理的做法后,主要结论是否仍然成立。
| 分析 | 目的 |
|---|---|
| 排除随访前 2 年内死亡 | 减少基线疾病导致的反向因果 |
| 排除基线心血管病和癌症 | 减少已有疾病的影响 |
| 多重插补(m = 5,10 轮) | 处理协变量缺失;结局、随访时间、暴露、权重和分层变量进入插补模型,用 Rubin 规则合并 |
| 不加权 Cox | 对照权重对结果的影响 |
原理与判断
对照
为什么做这一步同一数据库、同一指标,不同研究的结果为什么不同。
几项研究的共同结论是:四分位数趋势检验不显著,但 RCS 显示非线性。两者不矛盾:趋势检验只检验单调变化,RCS 允许曲线弯曲。拐点位置受年龄构成和协变量影响,8.88、9.18、9.364 都不能直接当作临床切点。
| 研究 | 样本 | 主要结果 |
|---|---|---|
| Chen 等,2024 | 1999–2018,n = 17,118 | 全因 Q4 对 Q1 HR 0.93(0.76–1.14);RCS 图示阈值 8.88,非线性 P = 0.0071 |
| Wang 等,2024 | 2001–2018,n = 15,388 | 全因 Q4 HR 1.02(0.62–1.48);曲线先降后升 |
| Sun 等,2022 | 1999–2014,≥45 岁,n = 9,254 | 全因连续 HR 1.01(0.93–1.10);拐点 9.18 |
| 本页 | 1999–2018,≥20 岁,n = 22,894 | 全因连续 HR 1.03(0.95–1.12);U 形,最低点约 9.0,探索性分段点 9.364 |
参考与附录
运行记录
为什么做这一步说明数据来源与运行条件。
本页数字来自 2026 年 10 月 27 日在 Scientify 上的一次长周期研究任务。用户上传任务书后确认 6 条研究要求,Scientify 自行下载 100 个官方文件、解析死亡文件、合并权重、完成全部统计分析,并发现 cox.zph 用于加权模型时的尺度假象,改用时间交互检验。
最终交付 16 页中文报告、22 张图、表格、一键复现脚本和带 SHA256 的数据清单,独立审阅通过。从开始到审阅通过约 1.5 小时,全程使用云电脑 CPU,没有租用 GPU。
常见错误与处理
按出现频率排序。
用了 WTMEC2YR 做空腹指标的分析
原因:空腹血糖和甘油三酯只在空腹子样本中测量。
怎么解决:改用 WTSAF2YR(1999–2002 为 WTSAF4YR),多周期按年数比例合并。
下载的 XPT 文件读不出来,或文件只有几 KB
原因:CDC 调整了下载路径,旧地址返回 HTML 404 页面。
怎么解决:使用 /Nchs/Data/Nhanes/Public/<年份>/DataFiles/ 路径,下载后检查文件头。
加权结果的标准误异常小
原因:先删行再建 svydesign,破坏了抽样结构。
怎么解决:先用全样本建设计,再用 subset() 取分析人群。
死亡文件读出来列错位
原因:把定宽 .dat 文件当作分隔符文件读取。
怎么解决:按 NCHS 官方读取程序的列位置读取,SEQN 为第 1–6 列。
TyG 数值明显偏大
原因:NHANES 的 mg/dL 值又乘了一次换算系数。
怎么解决:LBXTR、LBXGLU 已是 mg/dL,直接代入公式。
cox.zph 对 svycoxph 的 P 值接近 1
原因:权重尺度导致的假象,检验无效。
怎么解决:用时间分段交互项做设计校正的 Wald 检验。
survey 报 lonely PSU 错误
原因:子集中某个层只剩一个 PSU。
怎么解决:设置 options(survey.lonely.psu = "adjust"),并在方法中写明。