 Scientify
本页说明
教程- 这页解决什么
- 你想用 Boltz-2 预测蛋白–小分子复合物结构和结合亲和力,但不清楚怎么安装、需要多大显存、YAML 怎么写、输出字段怎么读,以及结果能信到什么程度。
- 适合谁
- 做药物化学、计算化学或结构生物学的研究生,会用 Linux 命令行和 Python。
- 读完你会得到
- 读完能在自己的 GPU 上跑通 Boltz-2,正确解释亲和力输出,并知道它在同系列排序中的实际表现和局限。
- 覆盖
- 安装、许可与 GPU 显存实测
- 带亲和力计算的 YAML 输入与 MSA
- 实际运行的命令与参数含义
- 输出文件、置信度字段和亲和力字段的读法与单位换算
- 21 个化合物的排序实测:Boltz-2、Vina、分子量和重原子数
- 3 个共晶结构的配体 RMSD 对照
- 不覆盖
- 蛋白–蛋白亲和力(Boltz-2 不支持)
- FEP 自由能计算
- AlphaFold 3 的使用方法(见 AlphaFold 3 指南)
主线步骤
第 1 步
为什么做这一步确认版本、许可和硬件,避免装好后才发现显存或依赖有问题。
Boltz-2 的代码和模型权重在 GitHub 仓库 jwohlwend/boltz 发布,许可为 MIT,可免费用于学术和商业用途。boltz.com 是开发团队成立的公司网站,提供另外的商业产品。不想安装时,NVIDIA NIM(build.nvidia.com)和一些第三方网站提供在线运行。
安装命令是 pip install boltz[cuda] -U。PyPI 上的当前版本为 2.2.1(2025-09-08),要求 Python 3.10 到 3.12。没有 NVIDIA GPU 时去掉 [cuda] 也能安装,但官方说明 CPU 版本明显更慢。建议在独立的虚拟环境中安装,并记录版本号和权重版本。
有些教程写 Boltz-2 至少需要 24 GB 显存。本页实测在 A10G(24 GB)上,299 个残基的蛋白加一个 21 到 37 个重原子的配体,显存峰值约 4.4 GiB,单个复合物 110 到 133 秒。这个结果使用了 MSA 抽样 512 条并关闭 cuEquivariance 内核,蛋白更长或 MSA 更深时显存会增加。
python -m venv .boltz-env && source .boltz-env/bin/activate
pip install boltz[cuda] -U
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.get_device_name(0))"
boltz predict --help | head| 项目 | 实测值 |
|---|---|
| GPU | NVIDIA A10G 24 GB(AWS g5.2xlarge,8 核 CPU、32 GB 内存) |
| 软件 | boltz 2.2.1,Python 3.12,PyTorch 2.14 |
| 显存峰值 | 4,429 MiB(每 0.5 秒采样) |
| 内存峰值 | 约 8.4 GiB(单条命令) |
| 单个复合物耗时 | 平均 114 秒,110–133 秒(结构 1 个样本 + 亲和力 5 个样本) |
| 安装耗时 | 252 秒(复用镜像中的 PyTorch) |
第 2 步
为什么做这一步只有在 YAML 中写了 affinity 属性,Boltz-2 才会输出亲和力。
YAML 中每条链一个条目:蛋白写 id 和氨基酸序列,配体写 id 和 SMILES。properties 下的 affinity 用 binder 指定要计算亲和力的配体链。蛋白和配体的链 id 不能重复。
官方文档的限制是:一次只能对一个小分子计算亲和力;对象必须是配体,不能是蛋白、DNA 或 RNA;配体最多 128 个原子(含 RDKit 保留的氢),官方不建议明显超过 56 个原子。Boltz-2 只支持小分子与蛋白的亲和力,不能预测蛋白–蛋白结合强度。
MSA 是蛋白的多序列比对,用于提供进化信息。运行时加 --use_msa_server 会把蛋白序列发送到 MMseqs2 服务生成 MSA;也可以把已有的 a3m 文件路径写在 msa 字段。同一个蛋白算一组配体时,生成一次 MSA 后反复使用,既节省时间,也保证每个配体的输入一致。本例的 MSA 有 10,612 条序列。
version: 1
sequences:
  - protein:
      id: A
      sequence: MEMEKEFEQIDKSGSWAAIYQDIRHEASDFPCRVAKLP...
      msa: inputs/msa/protein.a3m
  - ligand:
      id: B
      smiles: 'O=C([O-])COc1c(C(=O)[O-])sc(-c2cccc(NC3CCN(S(=O)(=O)Cc4ccccc4)CC3)c2)c1Cl'
properties:
  - affinity:
binder: B第 3 步
为什么做这一步参数决定采样多少结构、亲和力取几个样本,以及显存占用。
最简单的命令是 boltz predict input.yaml --use_msa_server。input 可以是一个 YAML 文件,也可以是一个文件夹,文件夹中的每个 YAML 依次计算。
下面是本次对 21 个配体使用的完整参数。结构采样 1 个、亲和力采样 5 个,所有配体使用同一组参数和同一个随机种子,不给晶体模板或口袋约束。为了降低显存,本次加了 MSA 抽样和 --no_kernels,这与官方默认设置不同。
命令返回 0 不代表成功。官方程序可能捕获推理错误后仍然正常退出,所以每次运行后要检查结构文件、confidence JSON 和 affinity JSON 三个文件是否都生成。
boltz predict inputs/boltz/lig_23486.yaml --out_dir structures/boltz \
  --model boltz2 --devices 1 --accelerator gpu --seed 20261103 \
  --recycling_steps 3 --sampling_steps 200 --diffusion_samples 1 \
  --max_parallel_samples 1 --step_scale 1.5 \
  --sampling_steps_affinity 200 --diffusion_samples_affinity 5 \
  --max_msa_seqs 8192 --subsample_msa --num_subsampled_msa 512 \
--output_format mmcif --write_full_pae --write_full_pde --no_kernels| 参数 | 本次取值 | 作用 |
|---|---|---|
| --diffusion_samples | 1(默认 1) | 结构样本数;官方给出 25 个样本、10 次 recycle 为 AlphaFold 3 默认设置 |
| --recycling_steps | 3(默认 3) | 循环次数,增加会变慢 |
| --sampling_steps | 200(默认 200) | 扩散采样步数 |
| --diffusion_samples_affinity | 5 | 亲和力模块的采样数 |
| --subsample_msa / --num_subsampled_msa | 开启 / 512 | 只用部分 MSA 序列,降低显存 |
| --no_kernels | 开启 | 关闭 cuEquivariance 内核;内核不可用或报错时使用 |
| --use_potentials | 未使用 | 推理时加物理约束,改善几何合理性 |
| --affinity_mw_correction | 未使用 | 对亲和力输出加分子量校正 |
第 4 步
为什么做这一步两个亲和力字段用途不同,置信度不能当作结合强度。
每个输入在 predictions/<输入名>/ 下生成一个文件夹,包含结构文件 <输入名>_model_0.cif、置信度文件 confidence_<输入名>_model_0.json、亲和力文件 affinity_<输入名>.json,以及 pae、pde、plddt 的 npz 文件。
affinity_pred_value 是 log10(IC50),IC50 以 μM 为单位,数值越小结合越强。官方说明它用于比较同系列的活性分子,例如苗头到先导、先导优化阶段,不用于判断非活性分子。换算成 pIC50 用 6 − affinity_pred_value,例如 −1.55 对应 pIC50 7.55,约 28 nM。
affinity_probability_binary 是 0 到 1 的概率,用于从诱饵分子中区分结合物,适合苗头发现阶段。它不是 Kd,也不是实验活性的概率。
confidence_score、iptm、ligand_iptm、complex_plddt 衡量模型对结构几何的把握,越高越可信,但它们不表示结合强度。本次结果中,ligand_iptm 达到 0.96 的 2QBR 预测,配体 RMSD 仍有 5.34 Å。
| 字段 | 含义 | 怎么用 |
|---|---|---|
| affinity_pred_value | log10(IC50/μM),越小越强 | 同系列活性分子排序;pIC50 = 6 − 值 |
| affinity_probability_binary | 结合概率,0–1 | 区分结合物与非结合物 |
| confidence_score | 综合置信度,0–1 | 判断结构是否可信 |
| iptm / ligand_iptm | 界面置信度,0–1 | 判断配体位置是否可信,不代表亲和力 |
| complex_plddt | 局部结构置信度,0–1 | 判断局部几何是否可信 |
原理与判断
实测
为什么做这一步用公开实验数据检验 Boltz-2 在同系列先导优化中的排序能力。
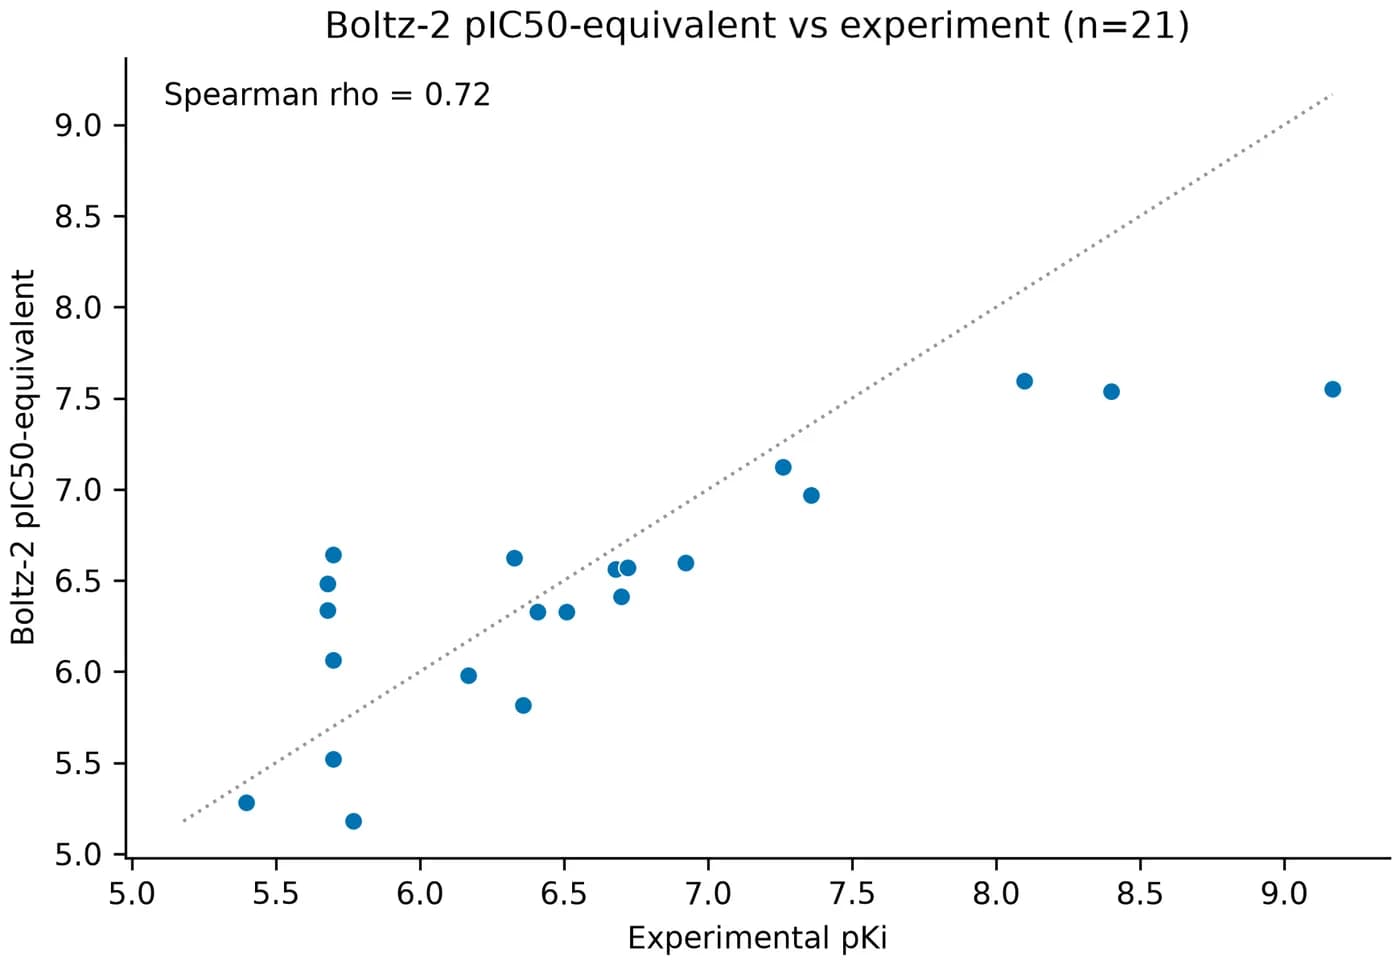
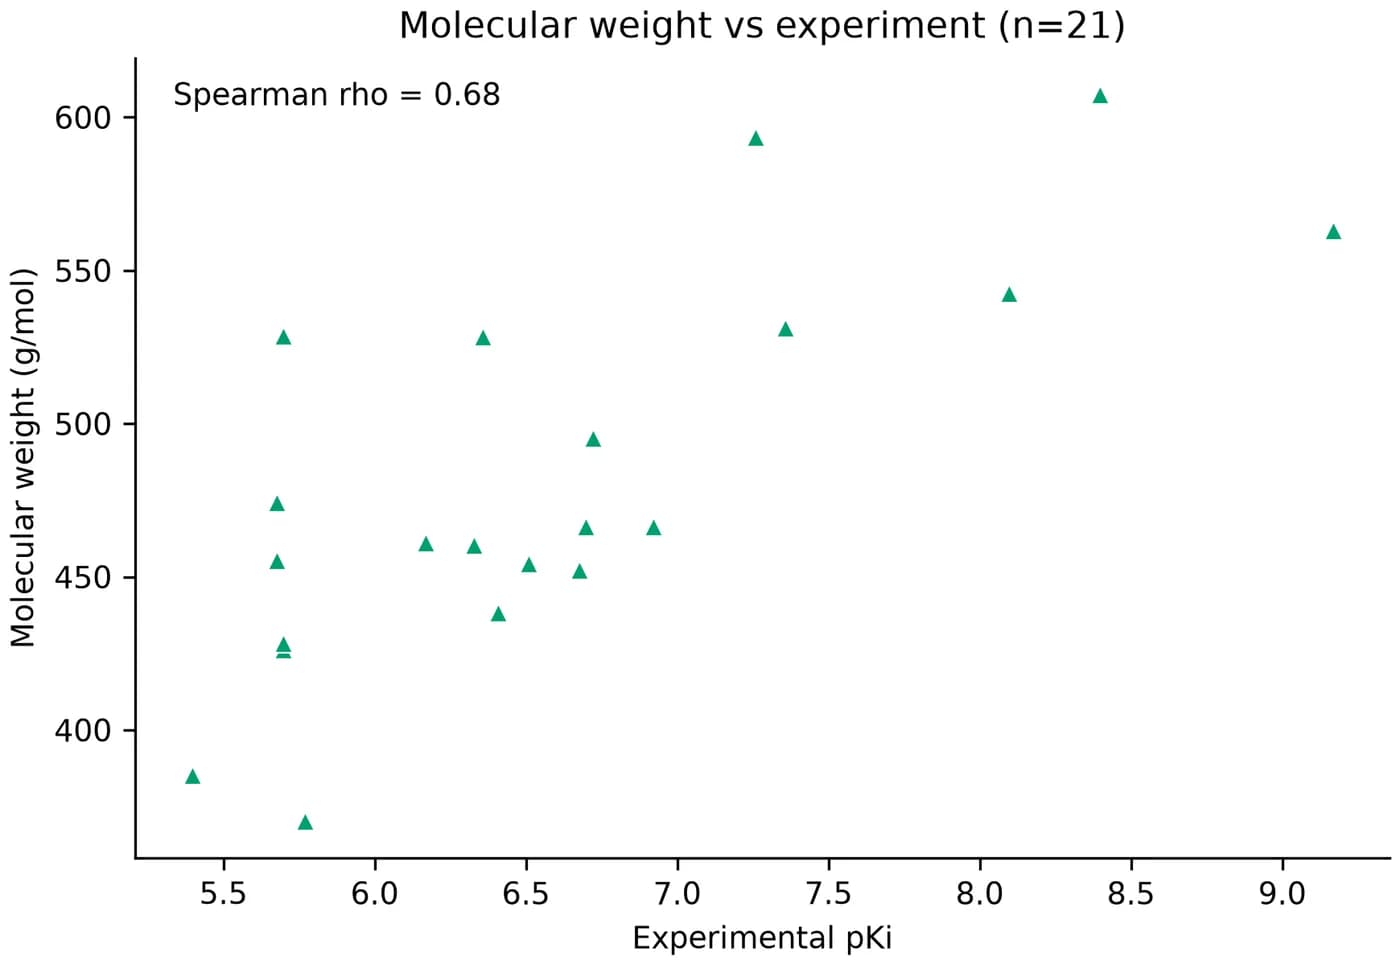
数据来自 Open Force Field protein-ligand-benchmark 中的 PTP1B 靶点。原有 22 个配体,其中 1 个与 ChEMBL 记录结构不一致,在预测前排除,最终 21 个,实验值为 Ki,pKi 范围 5.4 到 9.2。Vina 使用 2QBS 晶体受体和固定对接盒子,所有配体同一协议。另外用分子量和重原子数做基线,即“分子越大越强”这种最简单的排序。
结果:Boltz-2 的 Pearson 相关为 0.835,Vina 为 0.449。按化合物配对重抽样 20,000 次,Boltz-2 减 Vina 的三个相关系数差的 95% 置信区间都在 0 以上,说明在这个系列中 Boltz-2 明显好于 Vina。
但分子量基线的 Pearson 也有 0.751。Boltz-2 减分子量的相关系数差的置信区间都跨过 0,说明 Boltz-2 没有显著超过按分子量排序。在这个系列中,活性高的化合物多数分子也更大,大部分排序信息用分子大小就能得到。
实验最强的 lig_23486(Ki 0.68 nM)被 Boltz-2 排在第 2 位。实验 pKi 高于 8 的 3 个化合物,Boltz-2 预测值都在 7.5 左右,最强化合物的活性被低估。实验前 3 名都在 Boltz-2 的前 3 名中,所以它可以用来缩小候选范围,但不适合单独决定合成的先后顺序。
| 方法 | Pearson | Spearman | Kendall τ | 前 3 名命中 |
|---|---|---|---|---|
| Boltz-2 | 0.835 [0.668, 0.931] | 0.725 [0.373, 0.923] | 0.587 [0.299, 0.823] | 3/3 |
| AutoDock Vina | 0.449 [0.027, 0.789] | 0.447 [−0.039, 0.776] | 0.317 [−0.040, 0.618] | 2/3 |
| 分子量 | 0.751 [0.518, 0.898] | 0.684 [0.304, 0.893] | 0.525 [0.232, 0.759] | 2/3 |
| 重原子数 | 0.741 [0.383, 0.929] | 0.662 [0.271, 0.902] | 0.539 [0.223, 0.793] | 3/3 |
实测
为什么做这一步检查预测的配体位置和朝向是否与晶体结构一致。
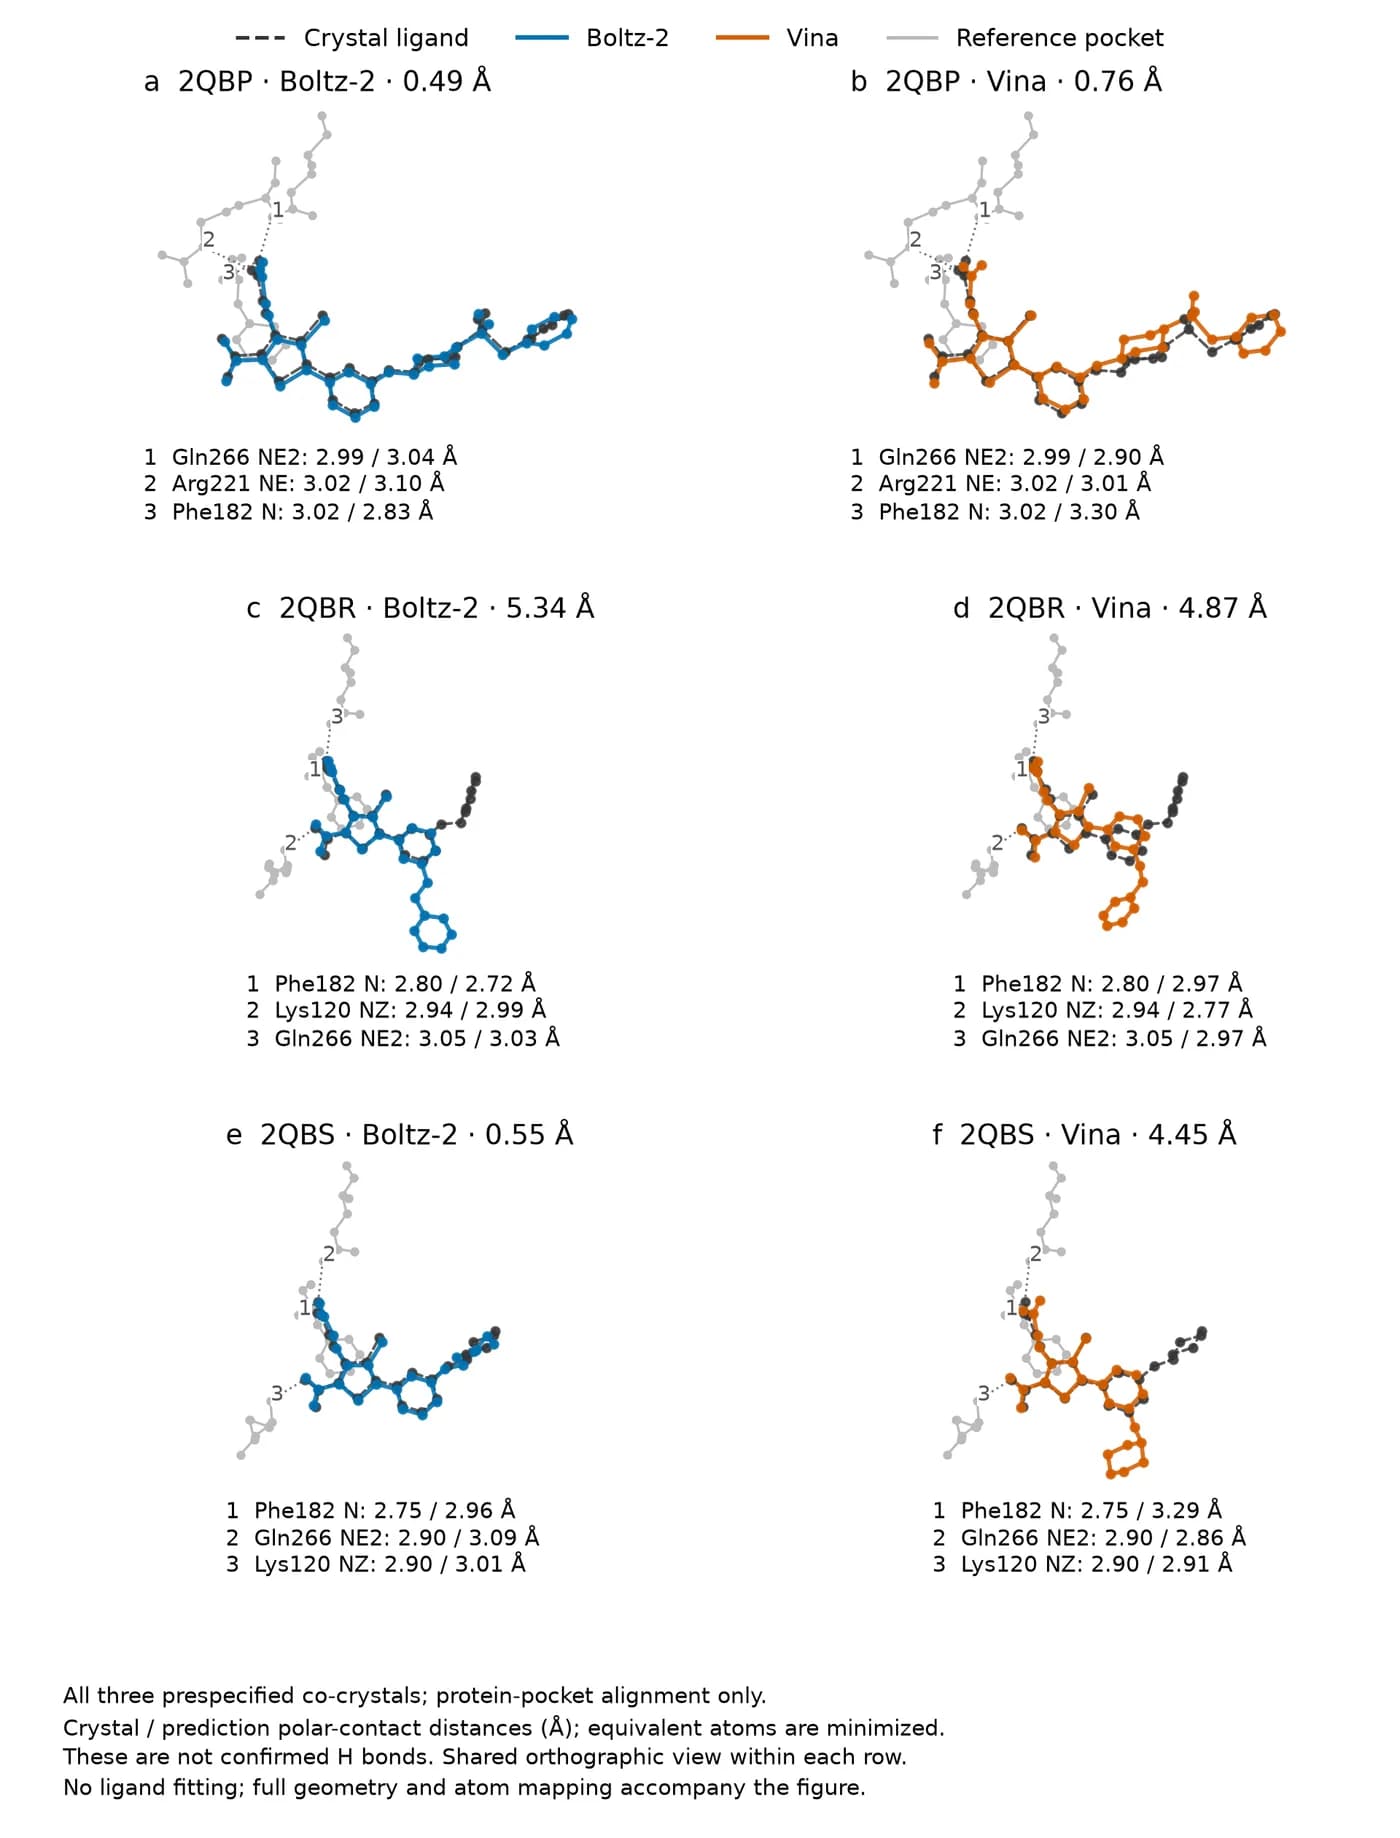
RMSD 的计算方法是:先按晶体配体 8 Å 内的口袋残基主链原子把预测蛋白叠合到晶体蛋白,再用同一变换移动预测配体,最后在考虑对称原子的情况下计算配体重原子 RMSD。直接把预测配体单独拟合到晶体配体上,会抹掉位置和朝向误差,结果偏小。
3 个共晶结构中,Boltz-2 有 2 个 RMSD 小于 2 Å(0.49 Å 和 0.55 Å),Vina 有 1 个(0.76 Å)。2QBR 上两者都失败,Boltz-2 为 5.34 Å,Vina 为 4.87 Å。只有 3 个结构,不能说明 Boltz-2 普遍更准。
这 3 个晶体结构 2008 年公开,早于 Boltz-2 结构训练数据的截止日期 2023-06-01,可能出现在训练集中。因此这个结果说明的是对历史公开体系的复现能力,不是对全新靶点的预测能力。
| PDB | Boltz-2 RMSD | Vina RMSD |
|---|---|---|
| 2QBP | 0.49 Å | 0.76 Å |
| 2QBR | 5.34 Å | 4.87 Å |
| 2QBS | 0.55 Å | 4.45 Å |
| 小于 2 Å | 2/3 | 1/3 |
按你的情况选择
选择
为什么做这一步两者都能预测蛋白–小分子复合物,区别在许可和亲和力输出。
AlphaFold 3 的代码以 Apache 2.0 许可发布,模型参数只能从 Google 直接获取并遵守其使用条款;非商业用户也可以用 AlphaFold Server 在线预测。Boltz-2 的代码和权重都是 MIT 许可,商业用途也可以使用。
AlphaFold 3 输出结构和置信度,不输出结合亲和力。需要给一组化合物排序时,Boltz-2 可以直接给出亲和力数值;只需要复合物结构时,两者都可以用,AlphaFold Server 不需要自己准备 GPU。
| 项目 | Boltz-2 | AlphaFold 3 |
|---|---|---|
| 代码许可 | MIT | Apache 2.0 |
| 模型权重 | MIT,公开下载 | 需从 Google 获取,遵守使用条款 |
| 亲和力输出 | 有 | 无 |
| 在线使用 | NVIDIA NIM 与第三方网站 | AlphaFold Server(非商业) |
| 本地运行 | pip 安装 | 需从 Google 获取模型参数,按官方说明部署 |
参考与附录
运行记录
为什么做这一步说明数据来源、计算资源和独立审阅。
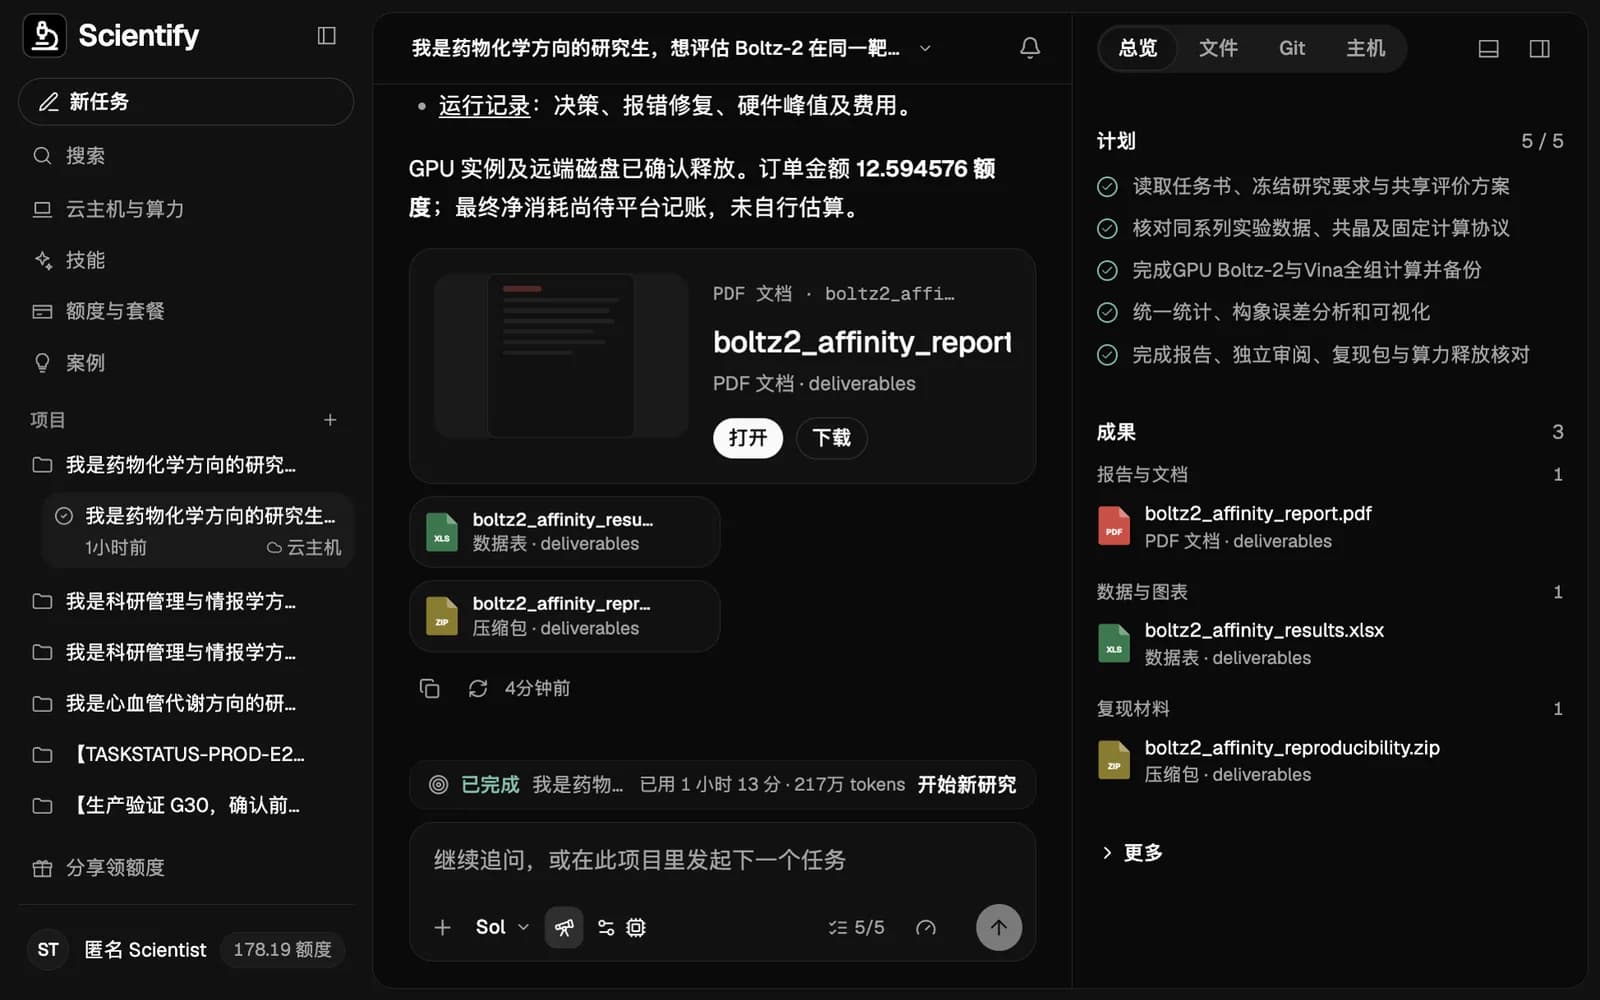
本页数字来自 2026 年 11 月 3 日在 Scientify 上的一次长周期研究任务。用户上传任务书后,Scientify 自行选择 PTP1B 靶点并核对实验数据,租用一台 A10G GPU,安装 Boltz-2,先跑 1 个复合物确认流程,再完成 21 个复合物的 Boltz-2 预测和 Vina 对接,结果回传并核对后释放 GPU。GPU 使用约 58 分钟,全程 1 小时 13 分。
运行中遇到 TensorBoard 与 protobuf 版本冲突导致首个样本失败,固定 TensorBoard 版本后重跑。独立审阅发现构象评估脚本会静默接受缺失的口袋原子,修复后重新审阅通过。最终交付 14 页中文报告、结果 Excel、8 张图、全部预测结构与对接构象、输入文件、代码和复现包。
常见问题排查
第一个样本就报 VersionError,提示 protobuf 版本
原因:环境中预装的 TensorBoard 需要更新的 protobuf,与 Boltz 依赖的 protobuf 版本冲突。
怎么解决:在独立虚拟环境中安装 Boltz,并固定兼容的 TensorBoard 版本(本次为 2.18.0)。这是环境问题,不影响模型结果。
有结构文件,没有 affinity JSON
原因:YAML 中没有写 properties 和 affinity,或 binder 没有指向配体链。
怎么解决:检查 properties → affinity → binder 是否等于配体的 id,并确认使用 boltz2 模型。
命令正常结束,但输出文件不全
原因:推理错误被程序捕获后仍返回 0。
怎么解决:每次运行后检查 cif、confidence 和 affinity 三个文件,缺失时查看日志。
CUDA out of memory
原因:蛋白较长、MSA 较深或并行采样过多。
怎么解决:设置 --max_parallel_samples 1,加 --subsample_msa 减少 MSA 序列;内核报错时加 --no_kernels。这些改动会改变计算设置,需要在方法中写明。
--use_msa_server 超时或失败
原因:MMseqs2 服务不可用或网络受限。
怎么解决:保存报错,稍后重试,或在本地生成 a3m 后写入 YAML 的 msa 字段。同一蛋白生成一次后反复使用。
参考资料
- Boltz GitHub 仓库 — 许可、安装与亲和力字段说明
- Boltz 预测文档 prediction.md — YAML 格式、亲和力限制与参数
- boltz(PyPI) — 版本 2.2.1,Python 3.10–3.12
- Passaro 等,Boltz-2 论文,bioRxiv 2025
- Open Force Field protein-ligand-benchmark
- PTP1B 抑制剂原始文献,J Med Chem 2007
- AlphaFold 3 GitHub 仓库